

AI真的能在红海获客了|为什么内部用AI生成的爆款开头不对劲?怎么改?(第三集)
Hi,大家好,我是珍妮。
今天和大家分享的是:
做自媒体平台,无论你做哪个平台——小红书、公众号还是视频号——你们赛道的爆款开头到底有没有什么办法,能让新手运营快速学会?
市面上有什么"小红书爆款开头生成器",或者让我用一些软件、Skills。
但你真的去用了就会发现,那些东西派不上用场:
它生成的东西和你的赛道格格不入。
只有你这个赛道长期做运营的管理层,才能察觉出【以上AI生成的内容】哪里不对劲;
而一个新手运营是察觉不出来的。
他直接用那些爆款开头生成器生成出来的东西,根本不可能获客成功。
当然,那些做软件的人也察觉不出来自己这个软件到底错在哪。
他们觉得只要投喂足够多的小红书爆款素材放进去,再自己调一下提示词,就能调出一个好的开头——实际上是错误的。
那么今天珍妮分享一下,这样的开头到底要怎么利用AI去改写,才是能成为爆款,且能吸引到客资的。
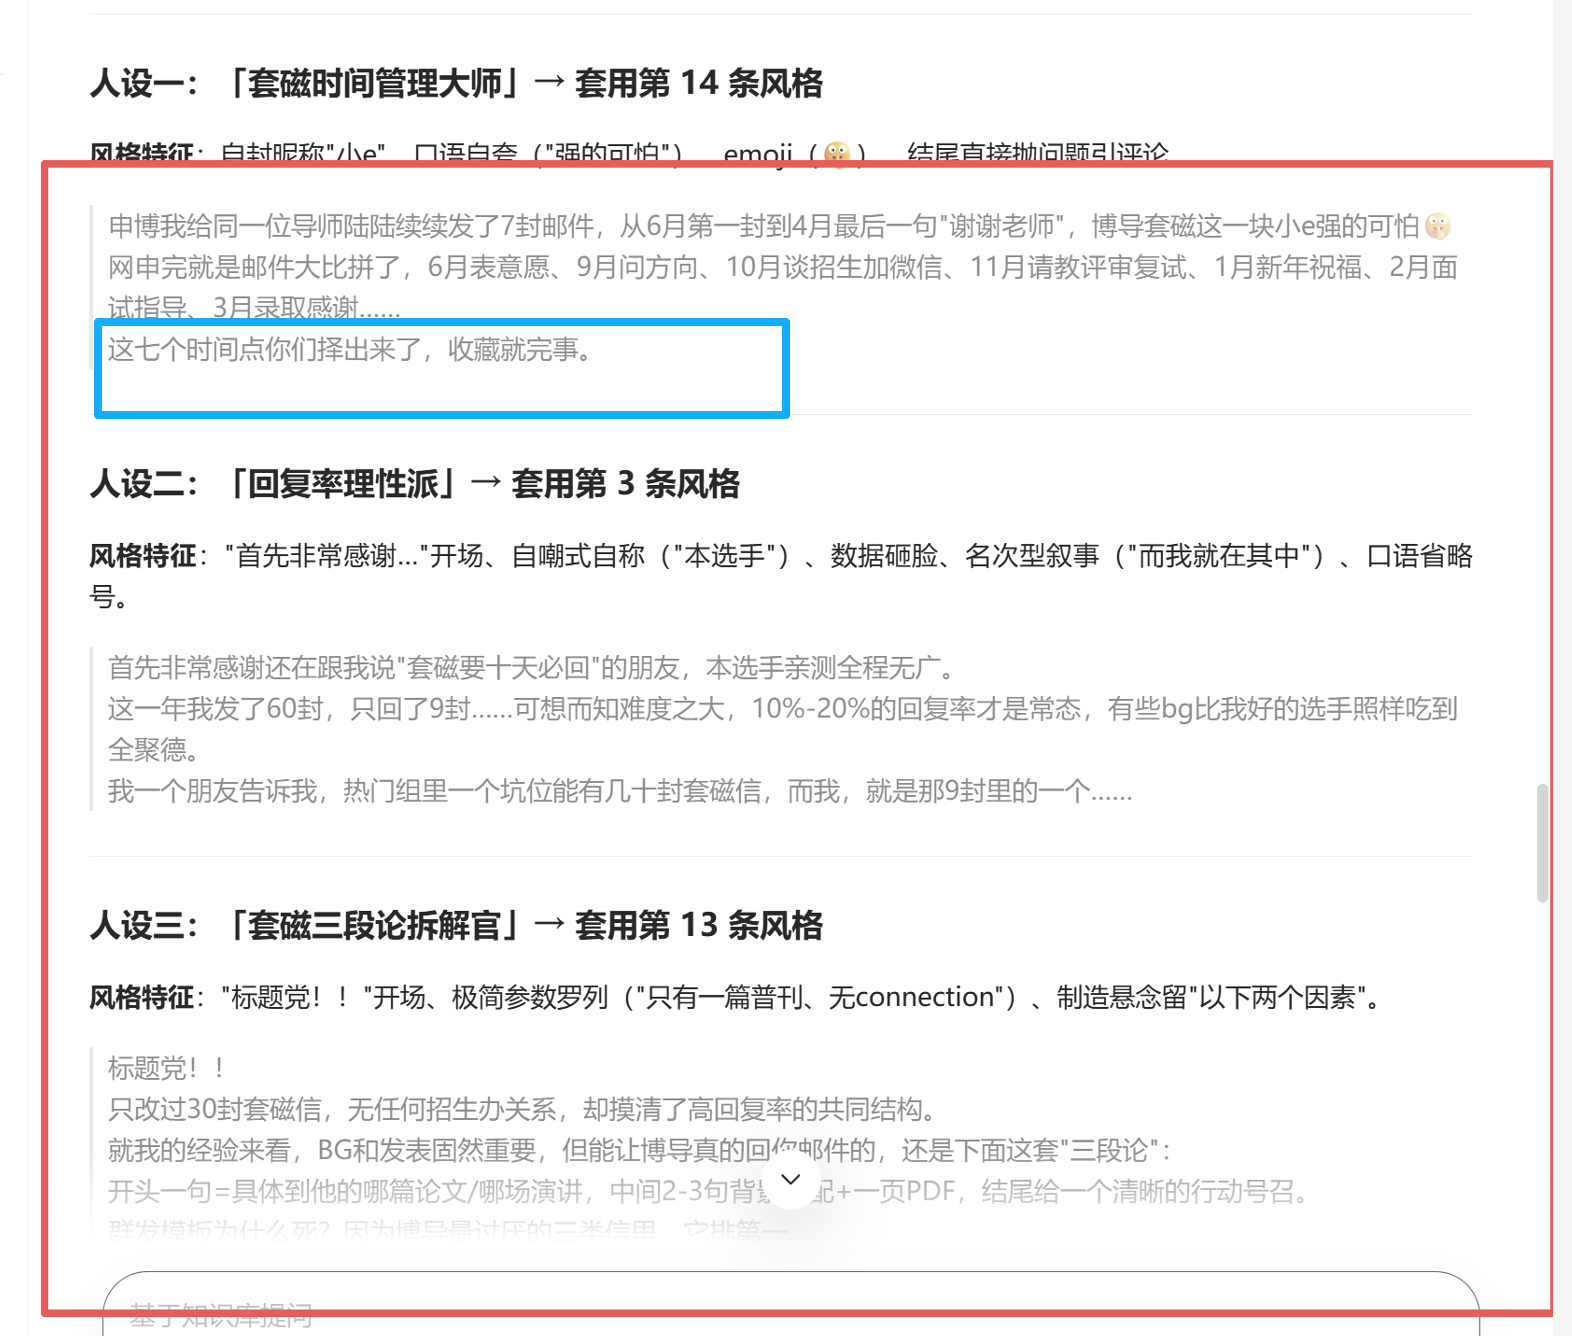
这是我们内部用AI生成的3个开头,
整个红圈里,只要把蓝圈那个句子删掉,或者把蓝圈改写一下,那么这个开头就已经天衣无缝了 。
而且调这个开头的步骤特别简单,
在内部基础建设做好的情况下,
不超过3个步骤,
不需要花钱买token,任何一个新人,都能写出来。
首先,做自媒体快速写稿的一个典型逻辑是:
第一,你要给AI投喂好的东西,而这个好东西必须是你自己先人工筛选、鉴别过的;
然后,你投喂的那个AI必须本身就懂你这个行业;
接着,它分析完一些东西之后,你再结合你们行业的内部知识库,让它生成一些新的东西。
我这么讲可能有点复杂,我稍后会在今天分享中讲一下具体的实操。
首先是第一点,要给AI投喂好的东西,而且是人工筛选过的东西。
这个是什么意思呢?
有些人做小红书是这样的:
他在小红书上面把各行各业的爆款全部采集进来,然后就去投喂了。
但是这个东西是有问题的——他搜集过来的那些爆款本身,可能就是由水军置顶起来的;
或者他搜集出来的爆款,是只有在蓝海赛道才能用的,在红海赛道那些东西是没有用处的。
所以他搜集的原始资料,相当于就没有用。
这时候,无论你跟这个AI怎么对话,
如果你指望这一款AI去给你搞定爆款开头什么的,是不可能的。
那么我们内部的爆款开头是怎么写出来的呢?
第一点,我们内部要去小红书上面搜集正确的素材,做成正确的内部素材库,然后我再去投喂AI。
那这个正确的素材库到底是怎么搜呢?
那就要用到第二层搜索词去搜。
第二层搜索词的整理,珍妮之前已经整理出来了,
用这个搜索词能够快速找到各行各业的第二层搜索词。
具体用法如下:
https://articles.zsxq.com/id_djfco8ii9nha.html
你对照上方文档提到的方法,你就能找到你们这个赛道真正的爆款。
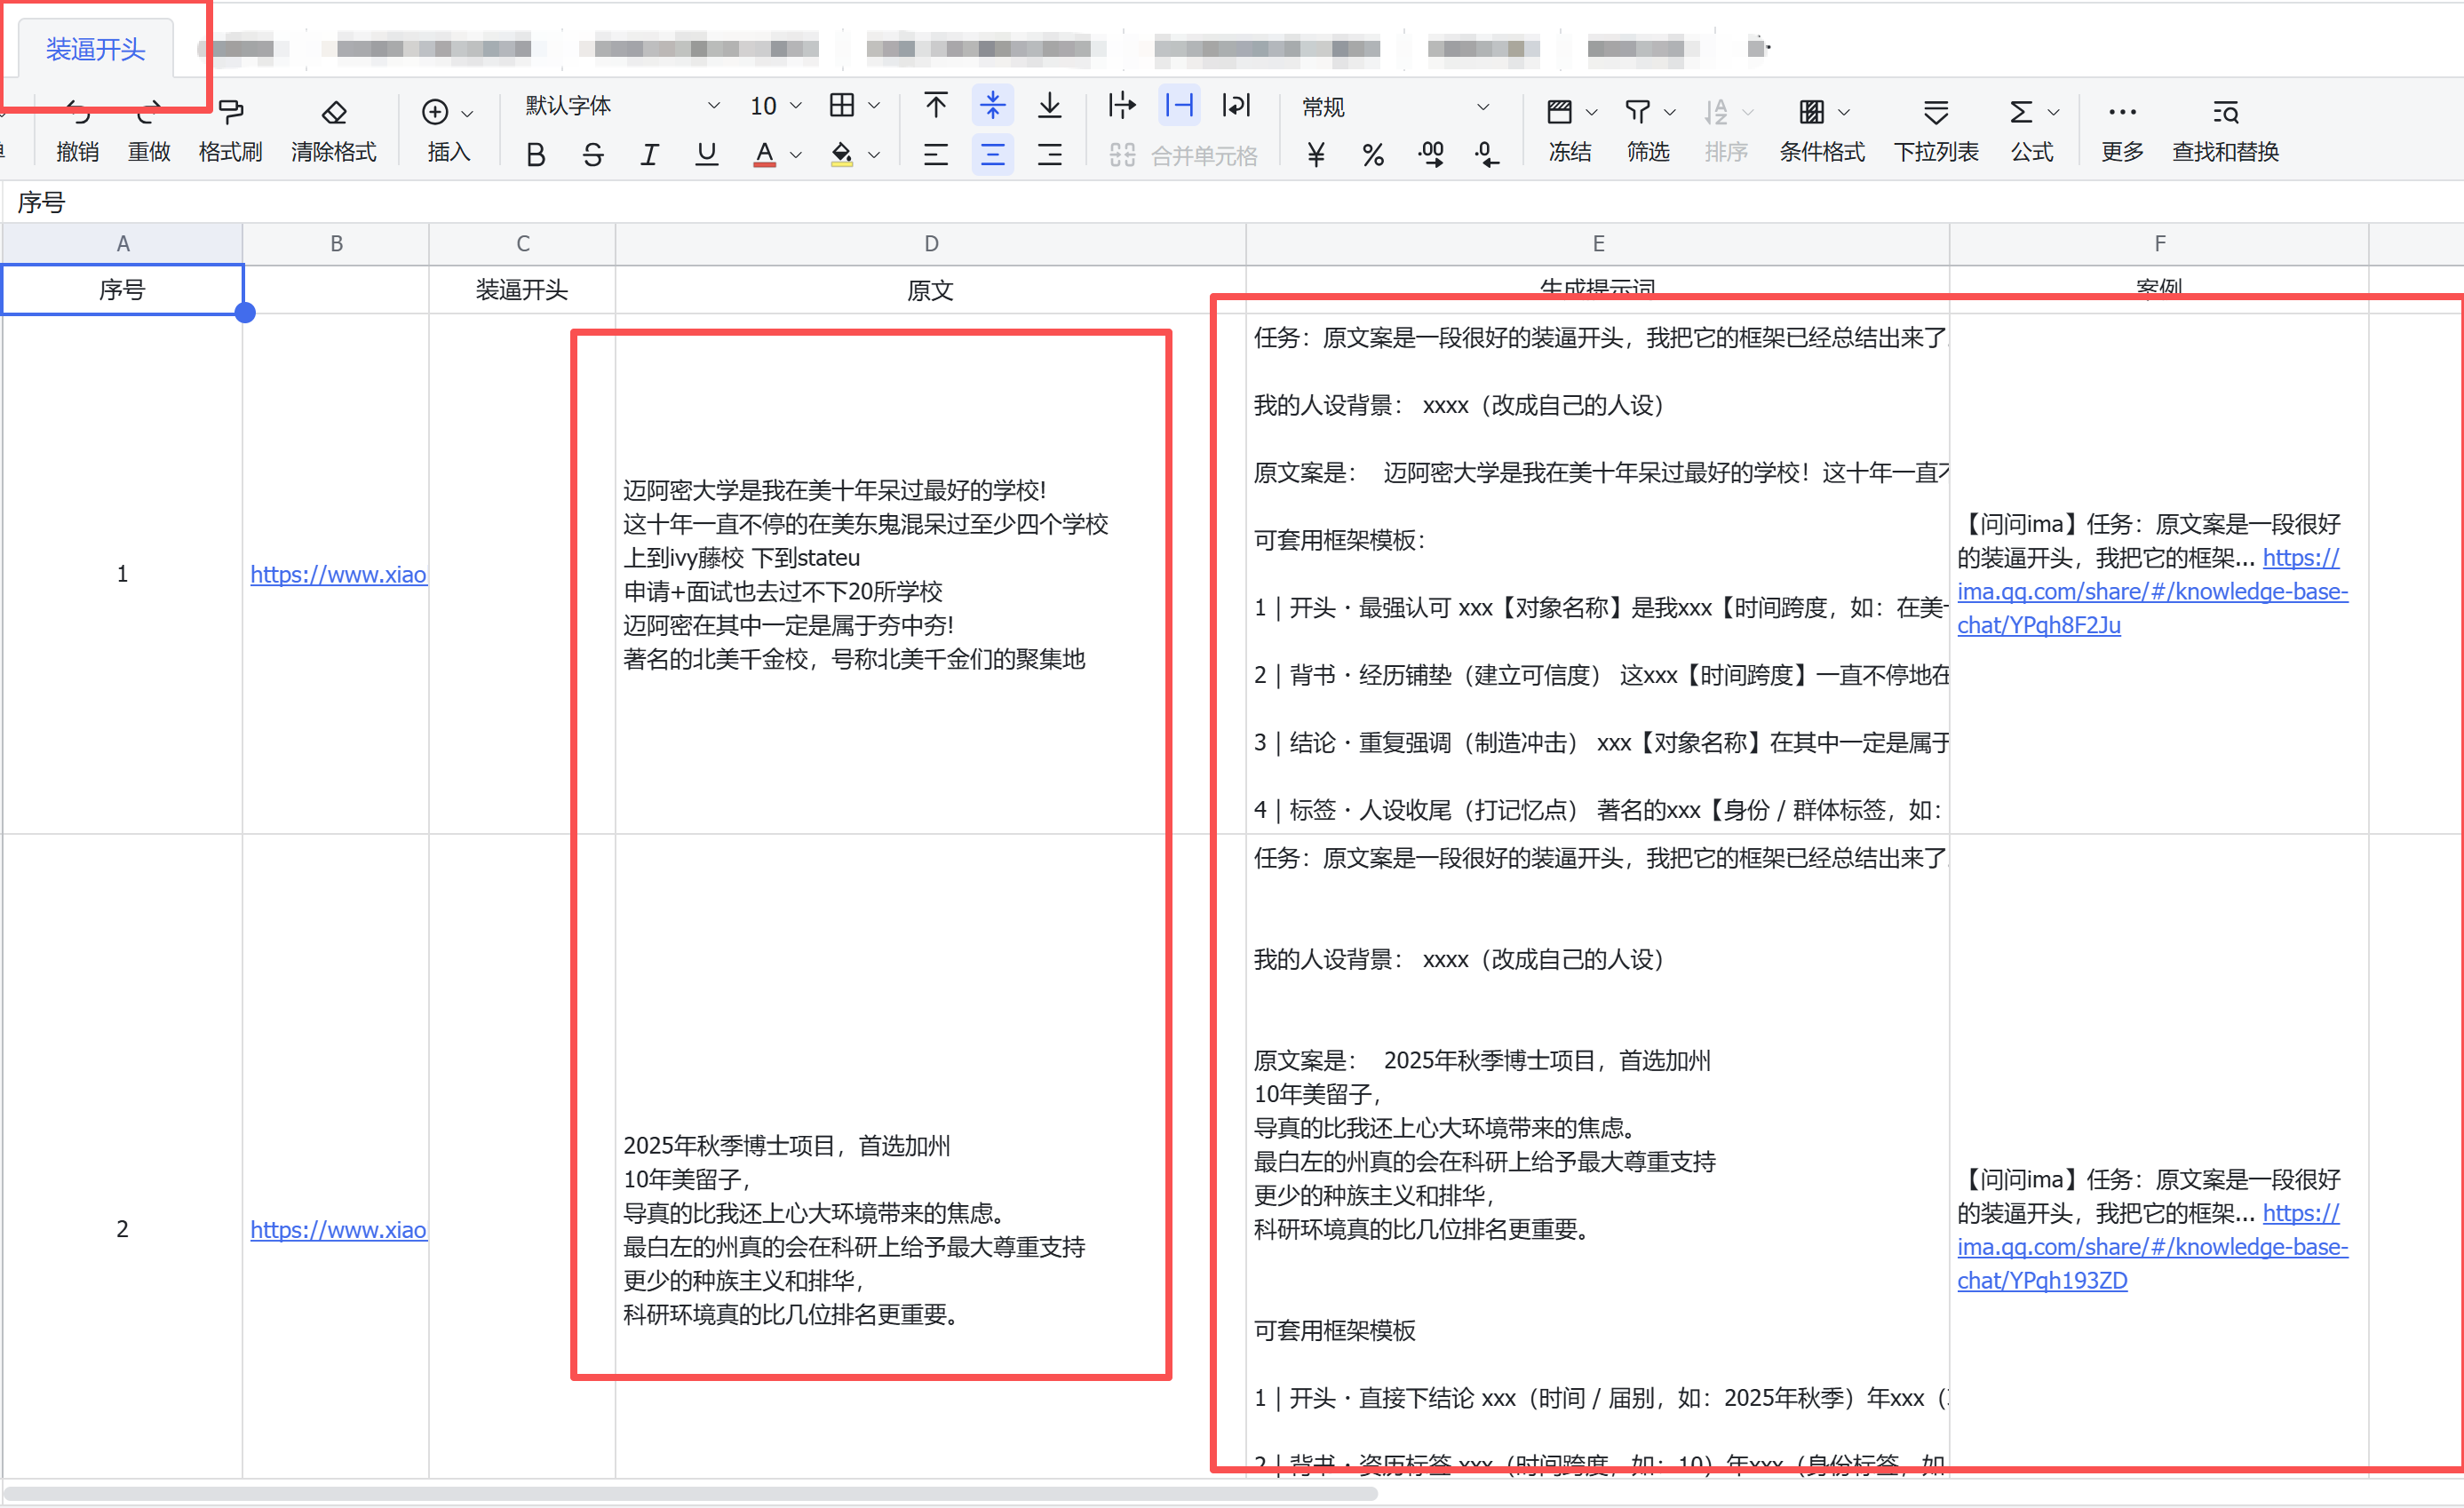
我们内部就是用这个办法,搜集到了相应的爆款,然后把相应爆款的开头单独拉出来做了一个表格。
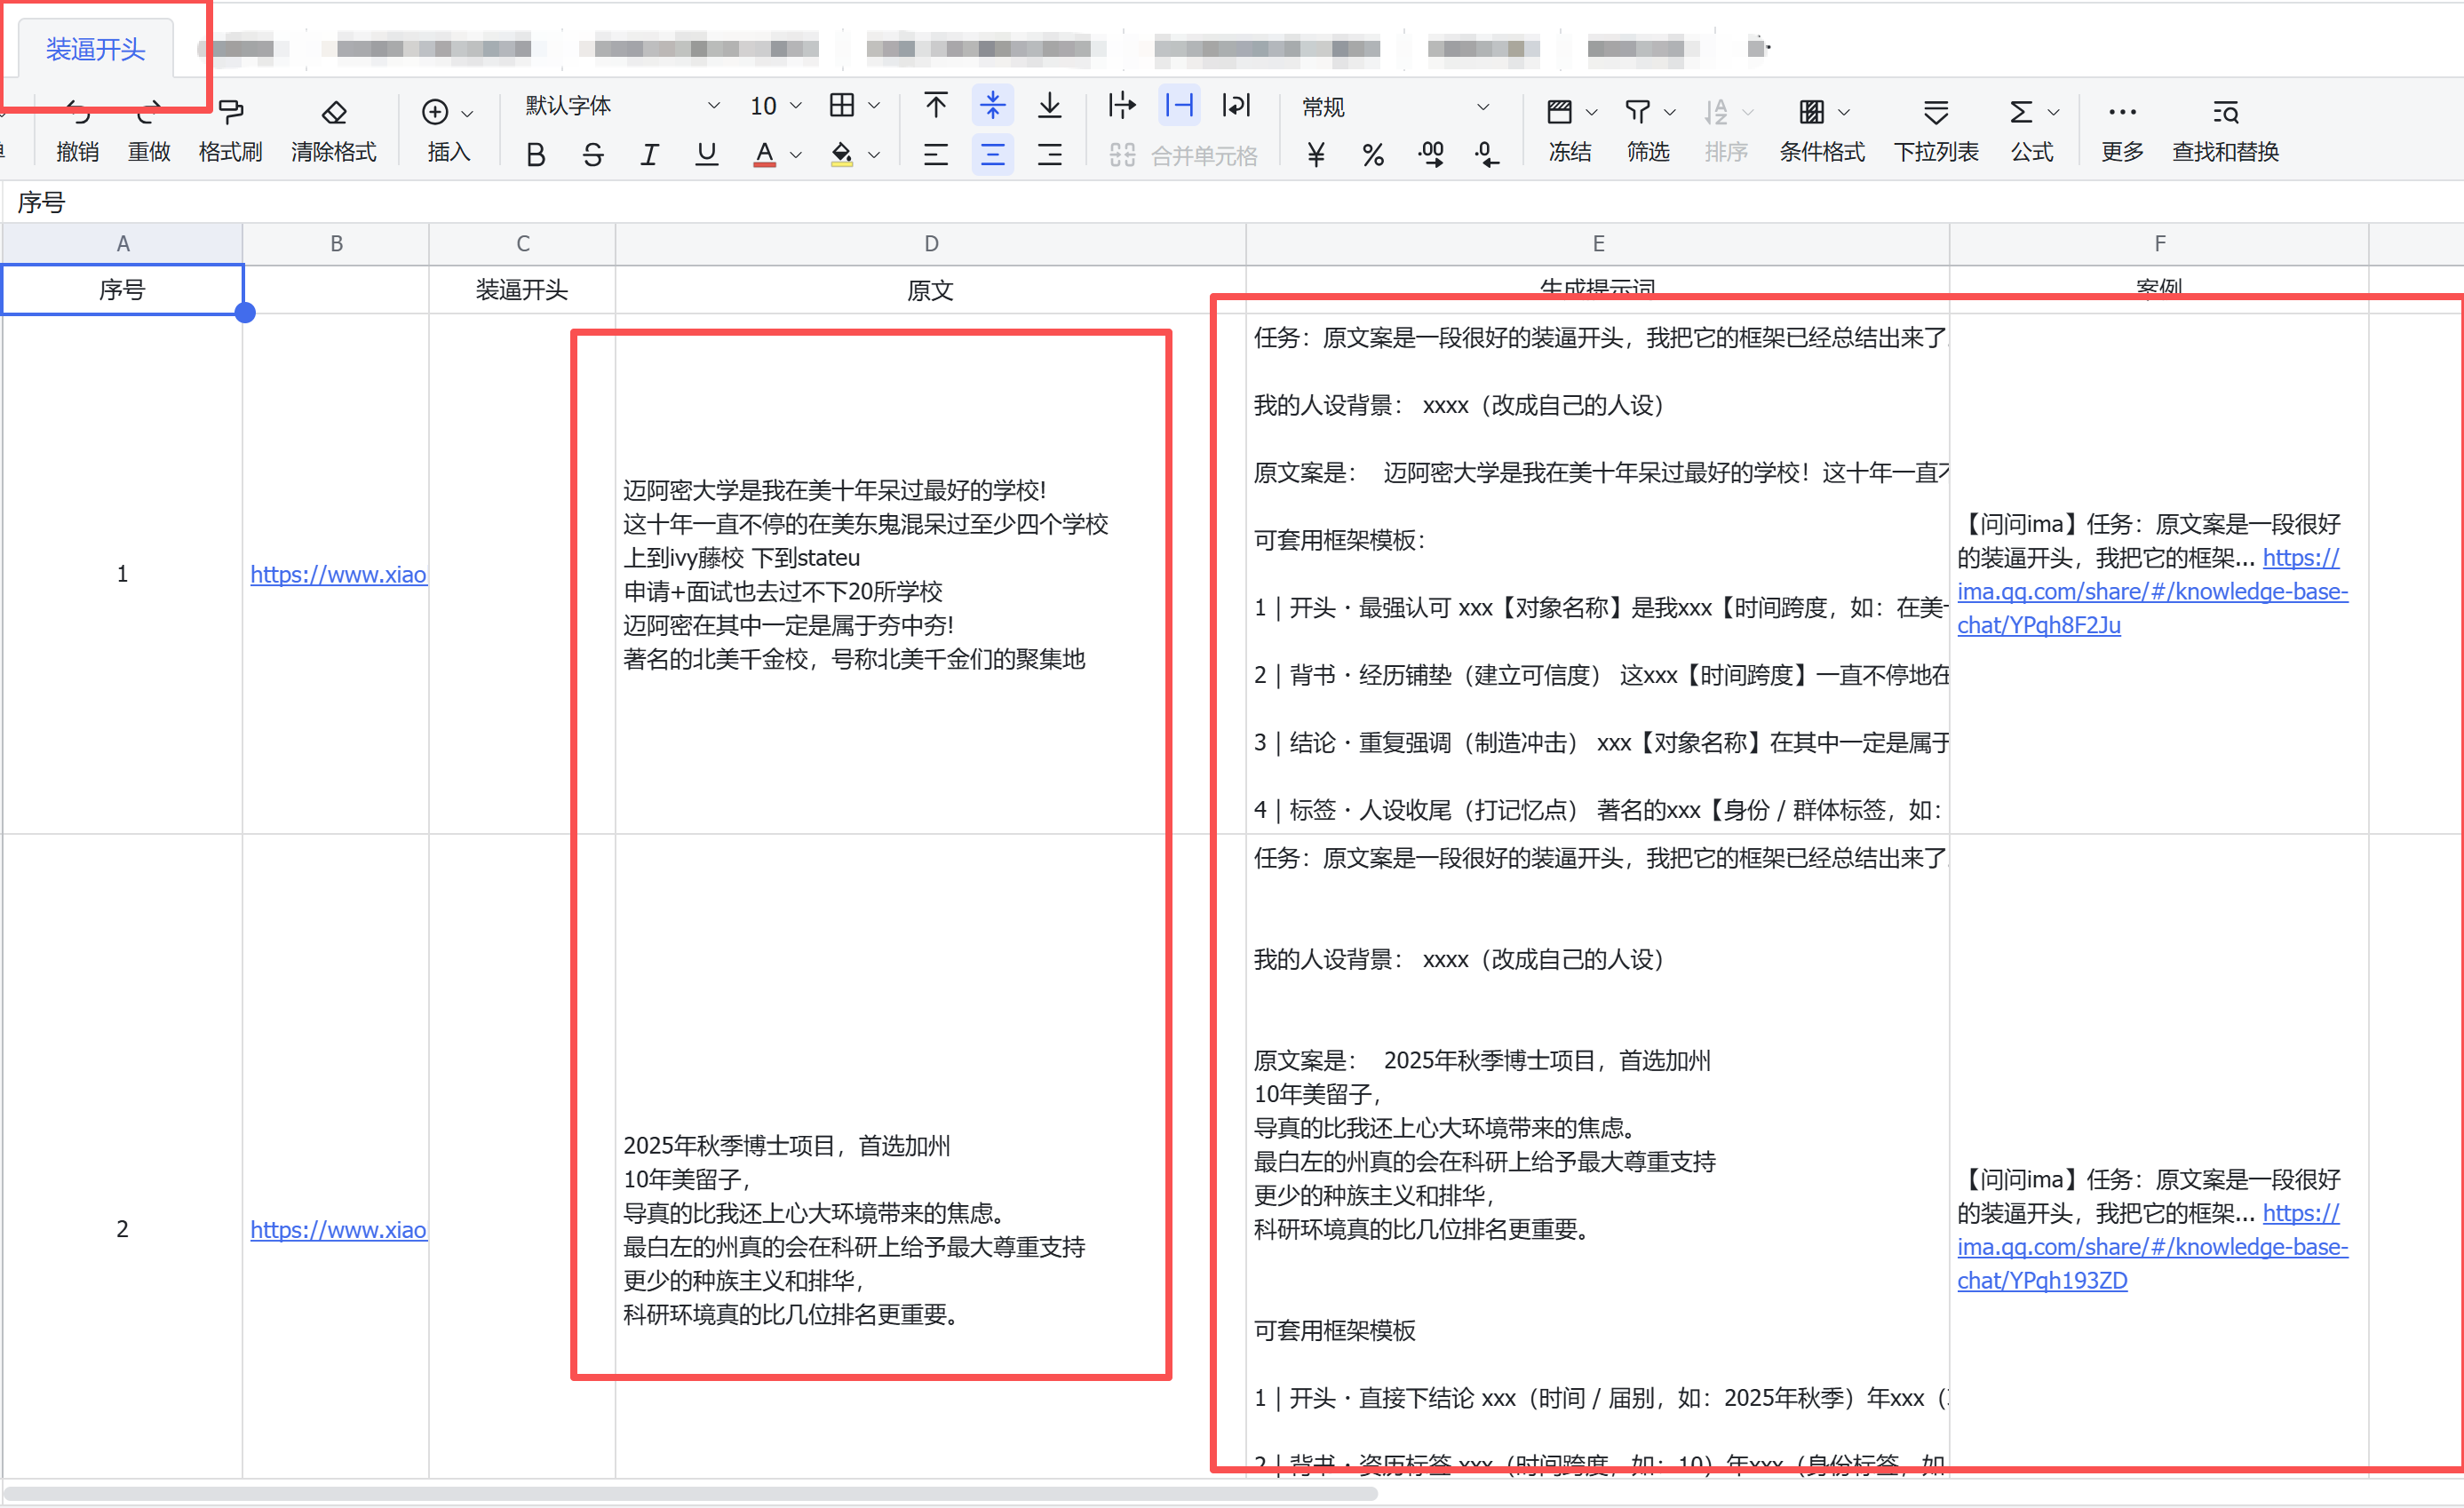
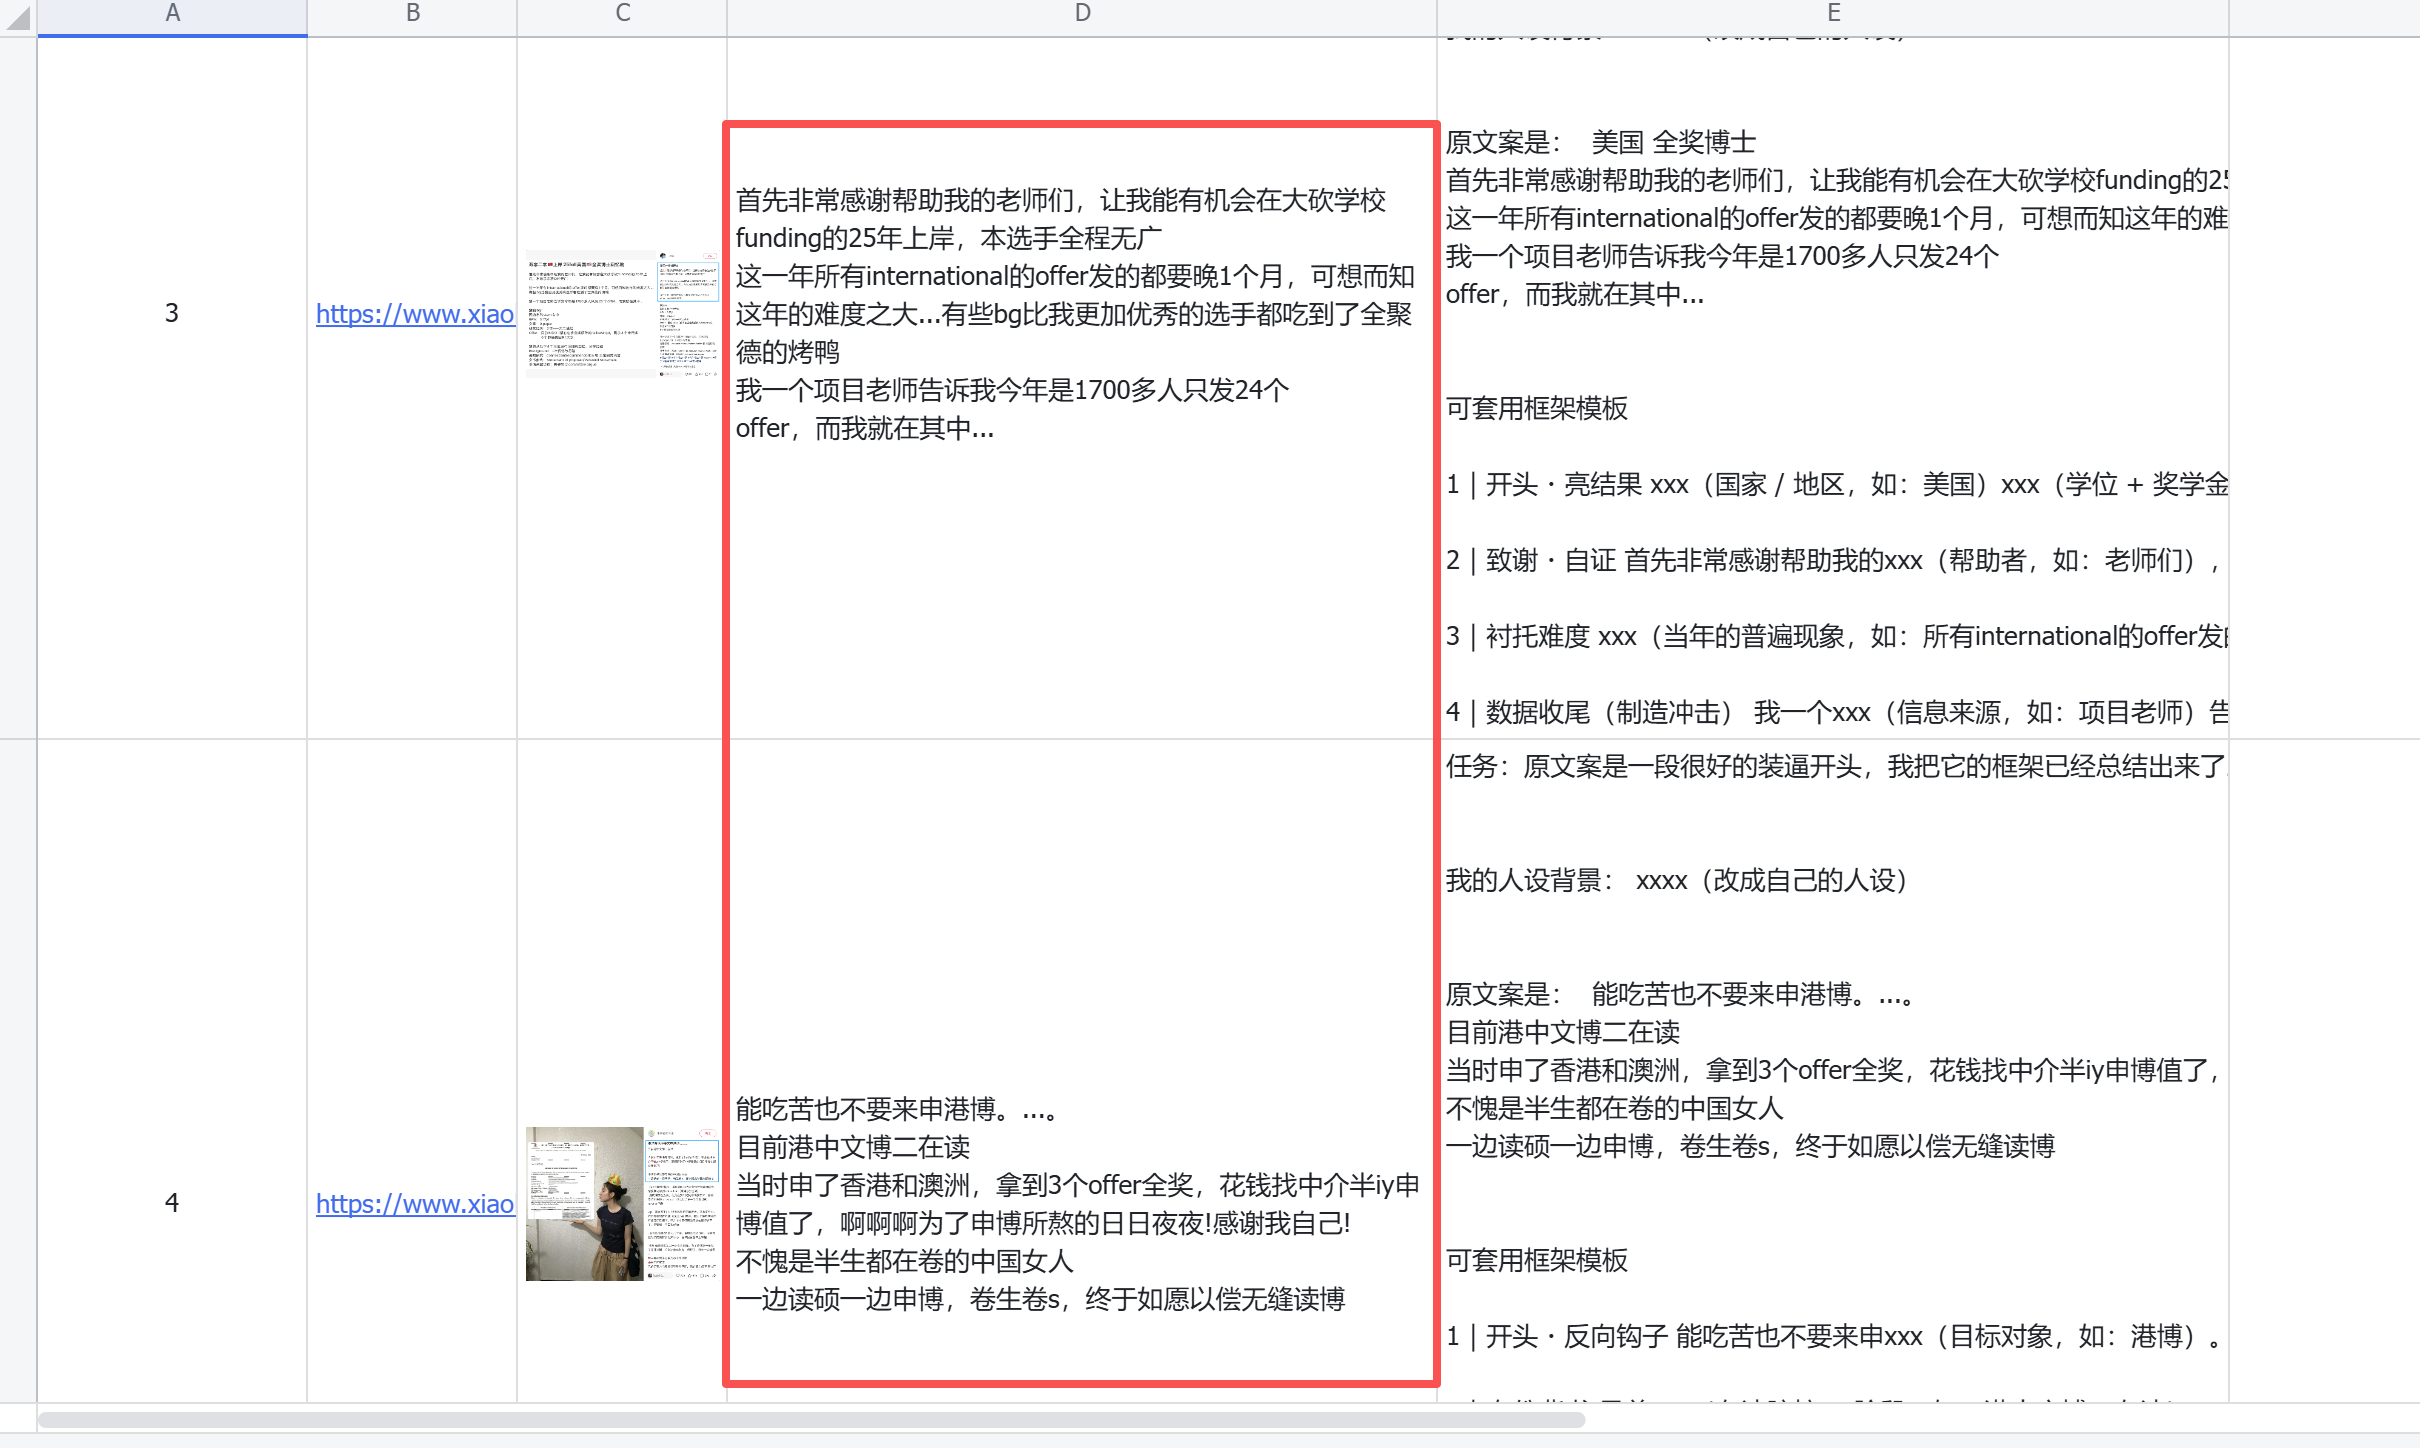
而且这样的表格,
我们确定:
1)它是从真正的爆款里面找出来的,
2)而且我们确定这个开头是值得学习的,我们才单独拉了一个表。
这个表格,是我们留学赛道专门会用到的“装逼开头”相关的表格,
因为我们留学赛道很需要在开头装逼,
所以我们精选了很多装逼开头的素材。
拉完这个表格之后,
我们要怎样把这个表格里面的爆款开头,快速生成N个爆款开头呢?
这就取决于我们要把这个表格,投喂到哪个知识库里面。
知识库有两种:
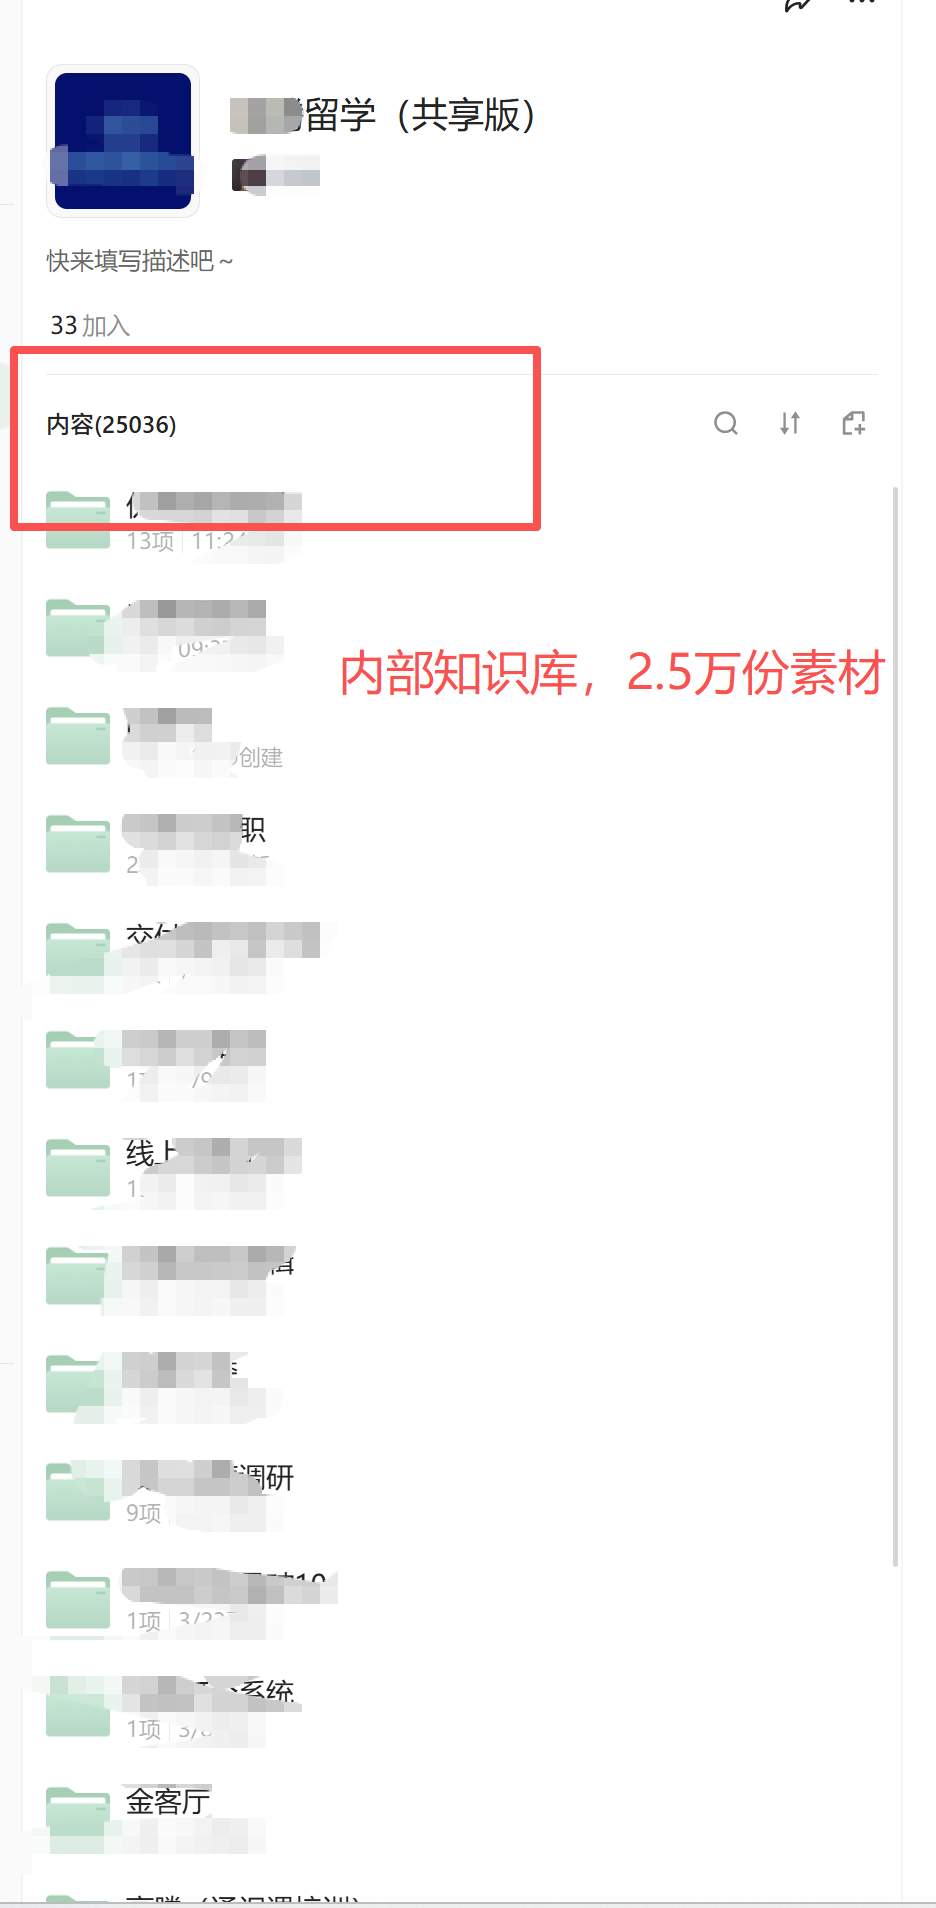
第一种是自己内部定制的知识库;
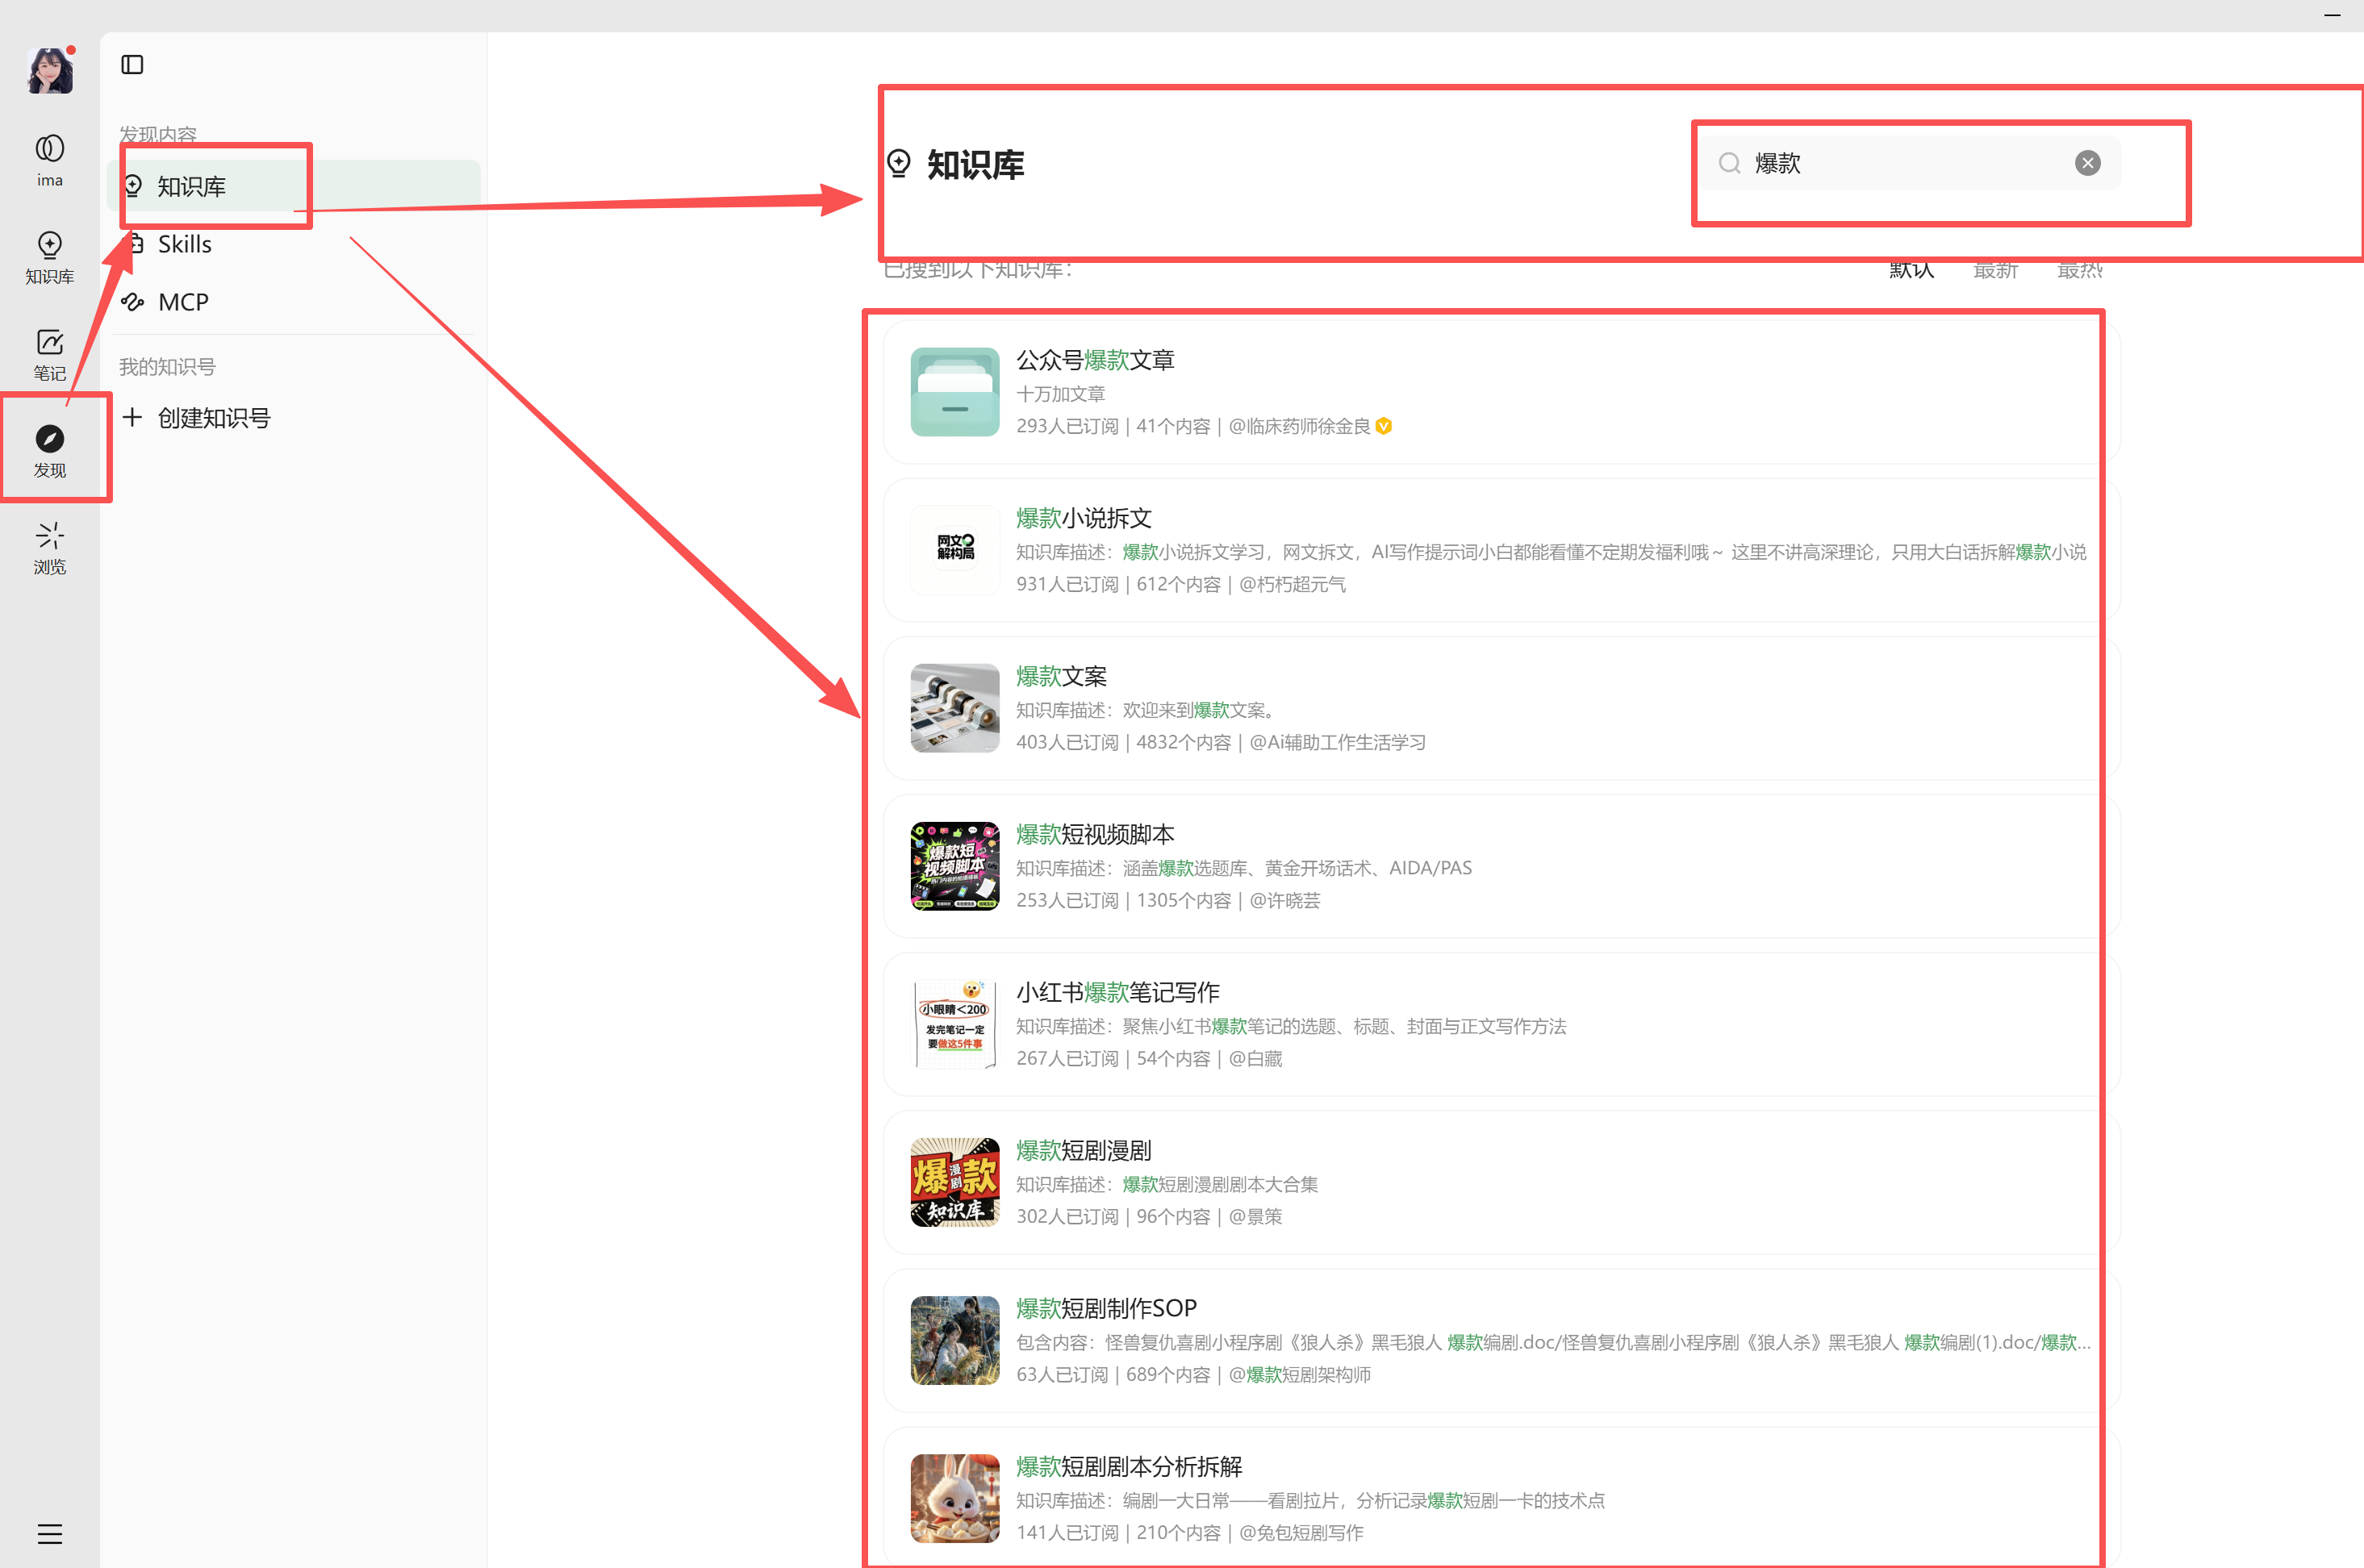
第二种是去腾讯IMA的知识库里面,搜集一些免费的知识库去加入,用别人已经整理好的一些资料。
别人的资料不一定特别好,但是有总比没有好。
虽然说别人的知识库可能只有70分,达不到你们内部定制的90分,
但是有一个70分的知识库,
总比你去直接跟GPT或者DeepSeek这种很通用的大模型数据去对话要好很多倍。
珍妮这时候就会用腾讯IMA去检索一个知识库。
比如我要写爆款开头,
我就会去腾讯IMA里面搜爆款——我可能搜小红书爆款、自媒体爆款、贴图号爆款、公众号爆款,
反正先都搜一下,
看一下哪个知识库订阅人数比较多、或者上传内容比较多,先都免费加入一下。
比如,我为了生成下方开头,
一共加入了三款知识库:
一款是小红书爆款知识库,
一款是自媒体10万加知识库,
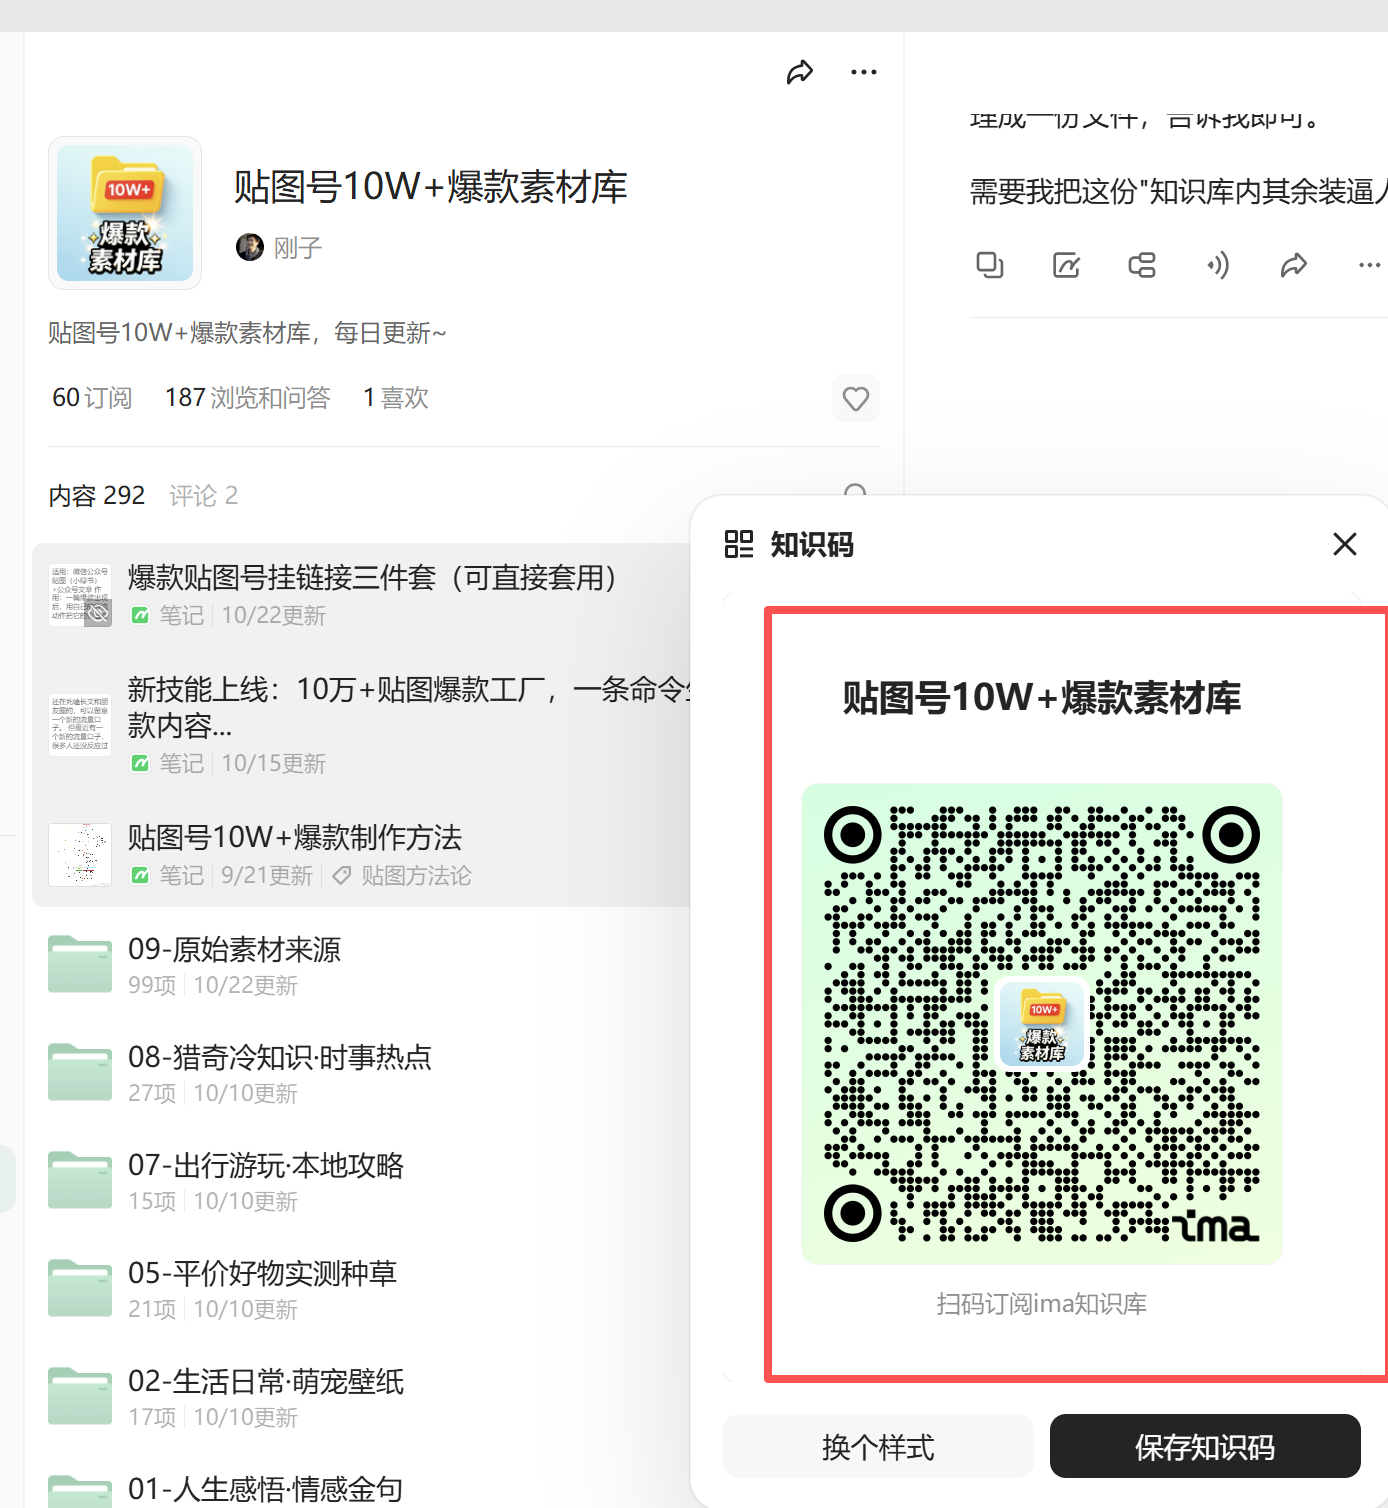
一款是贴图号10万+知识库。
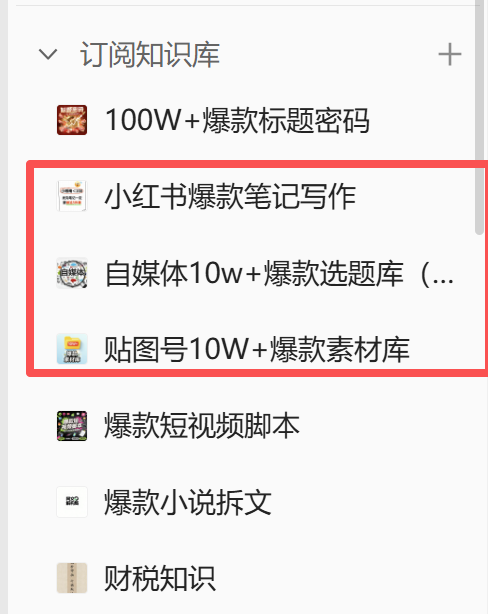
贴图号就是公众号的小绿书,
公众号的小绿书和小红书的打法是非常相似的,
所以贴图号的那些爆款本身,就是小红书的一些爆款,所以我会一块加入进去看看。
这三款知识库的二维码如下,全部可以免费加入,但是这三款知识库作用不一样,我会在下文提到。
在我去用别人公用的知识库之前,
我会先在内部处理一下我们已经搭建好的基础表格。
比如我会先回到内部那个我已经上传了的装逼开头知识库里面,
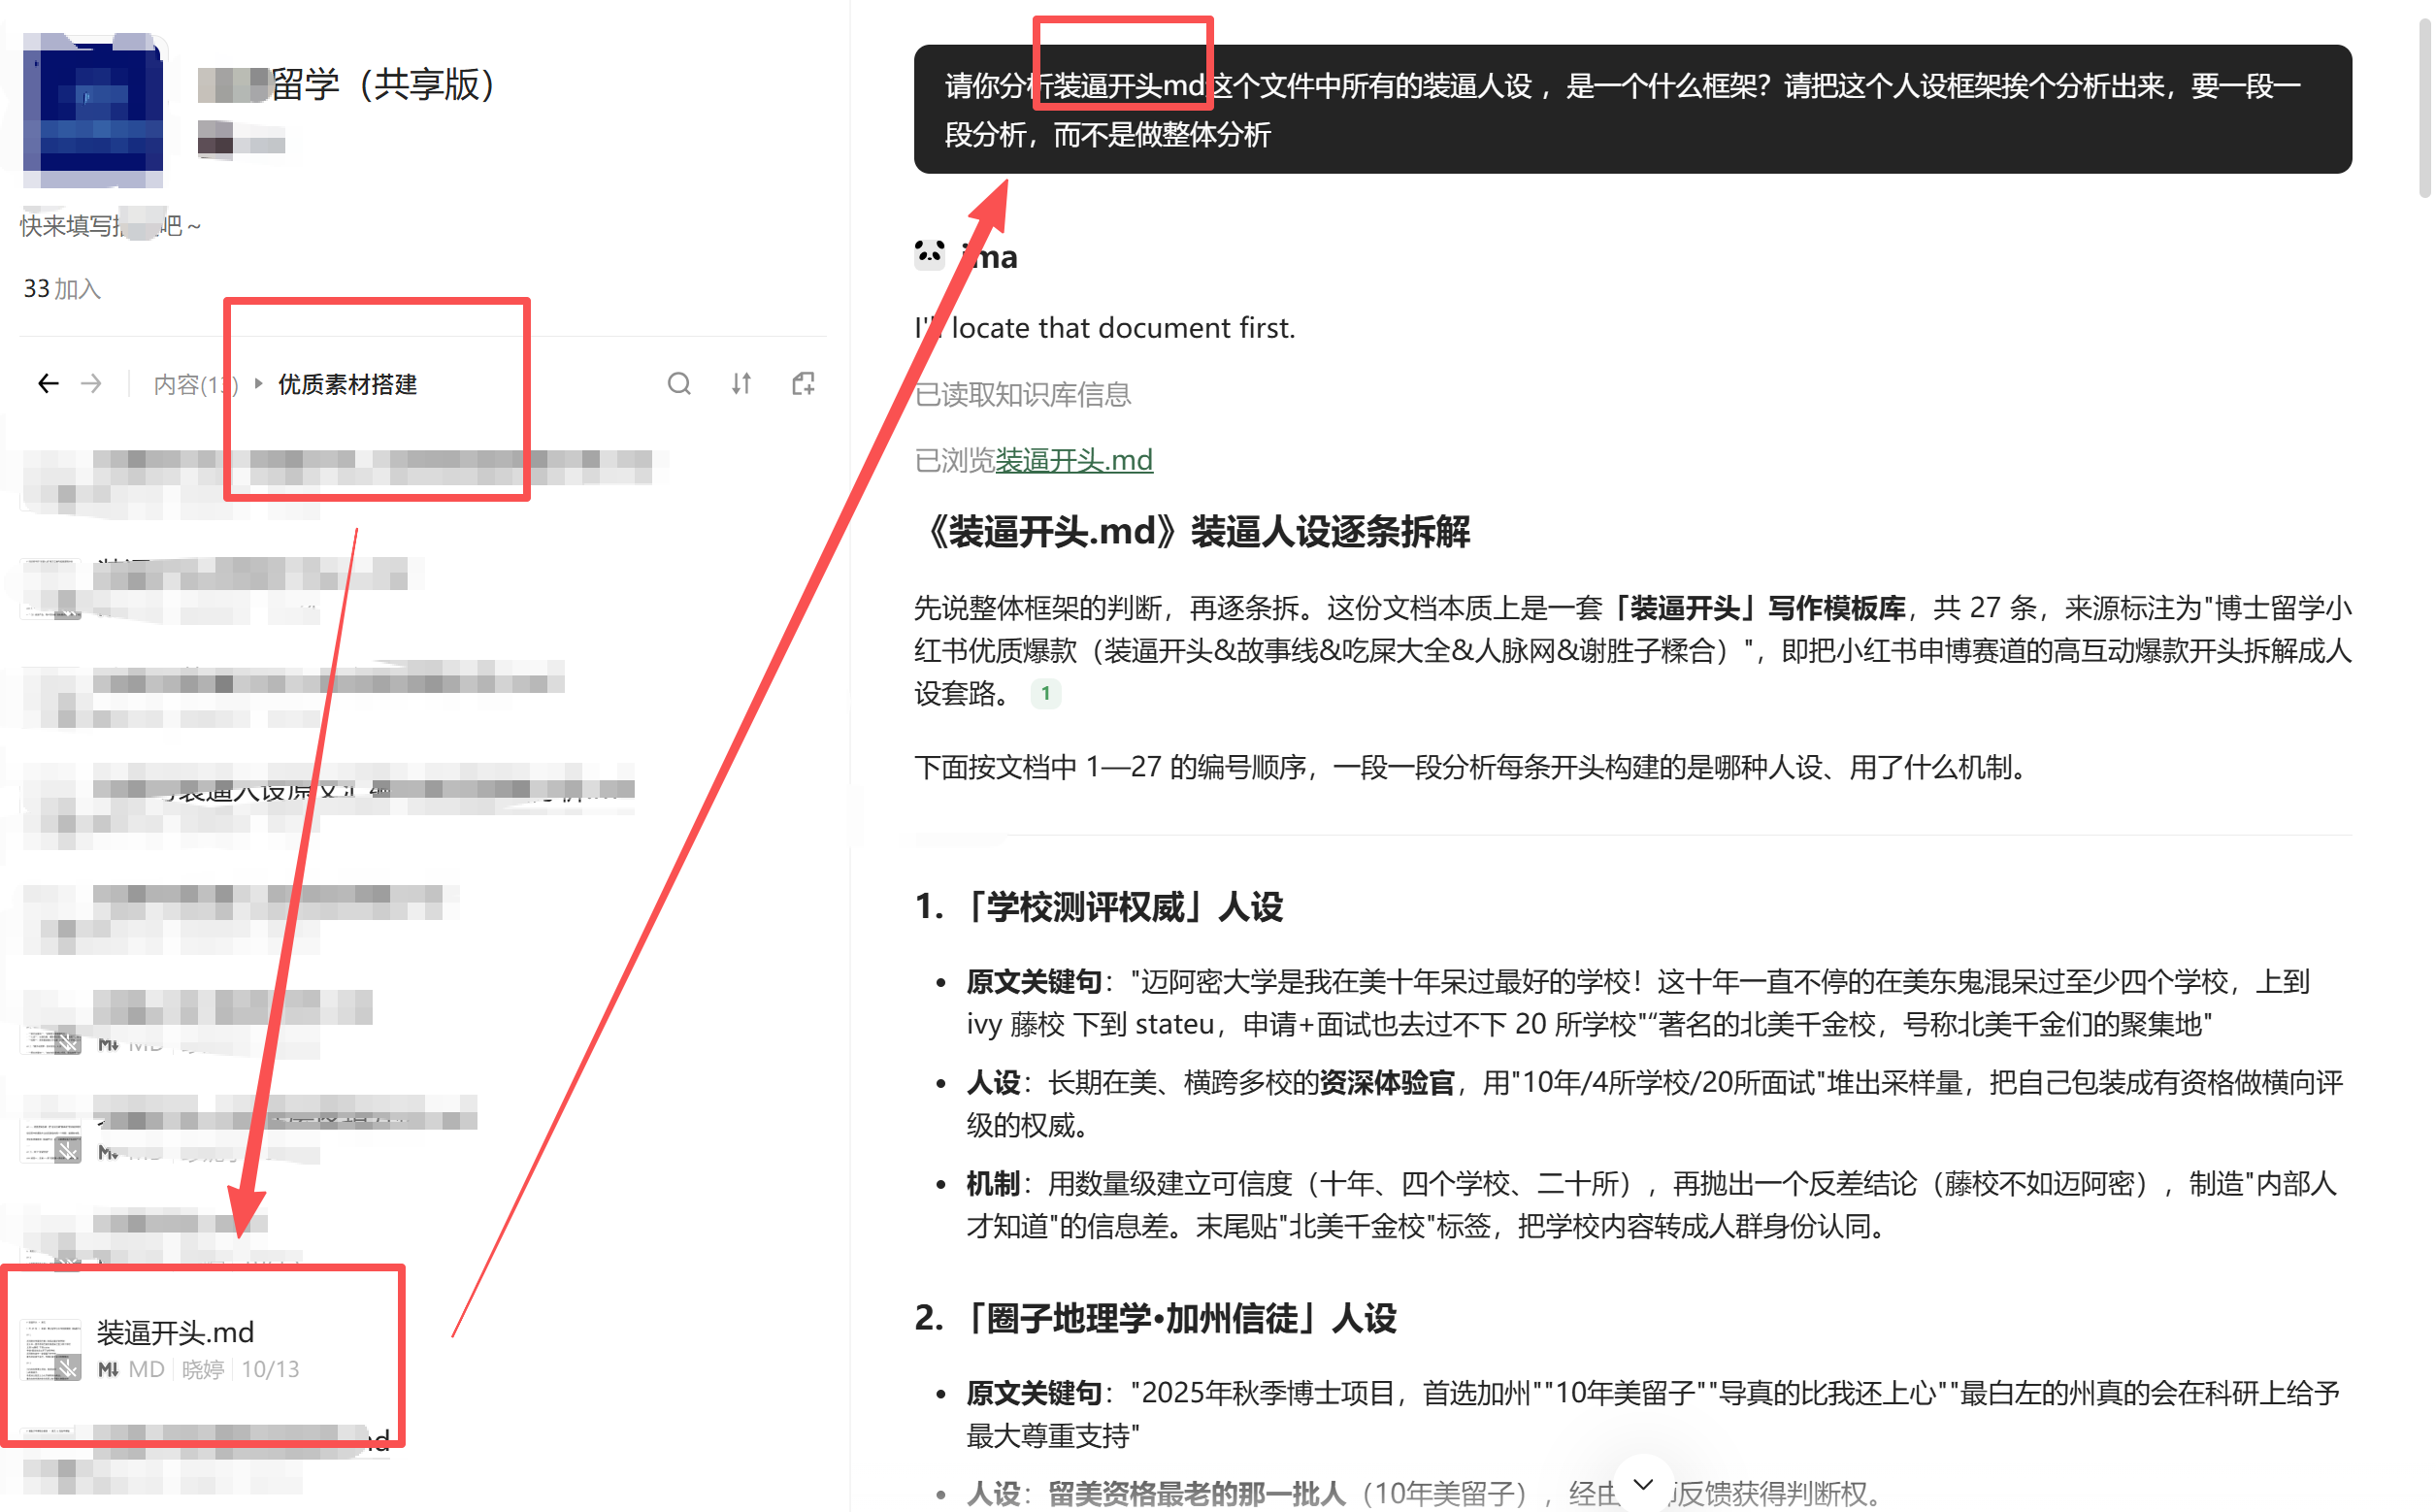
让AI去分析这个装逼人设到底是个什么样的框架,先让AI把框架分析出来。
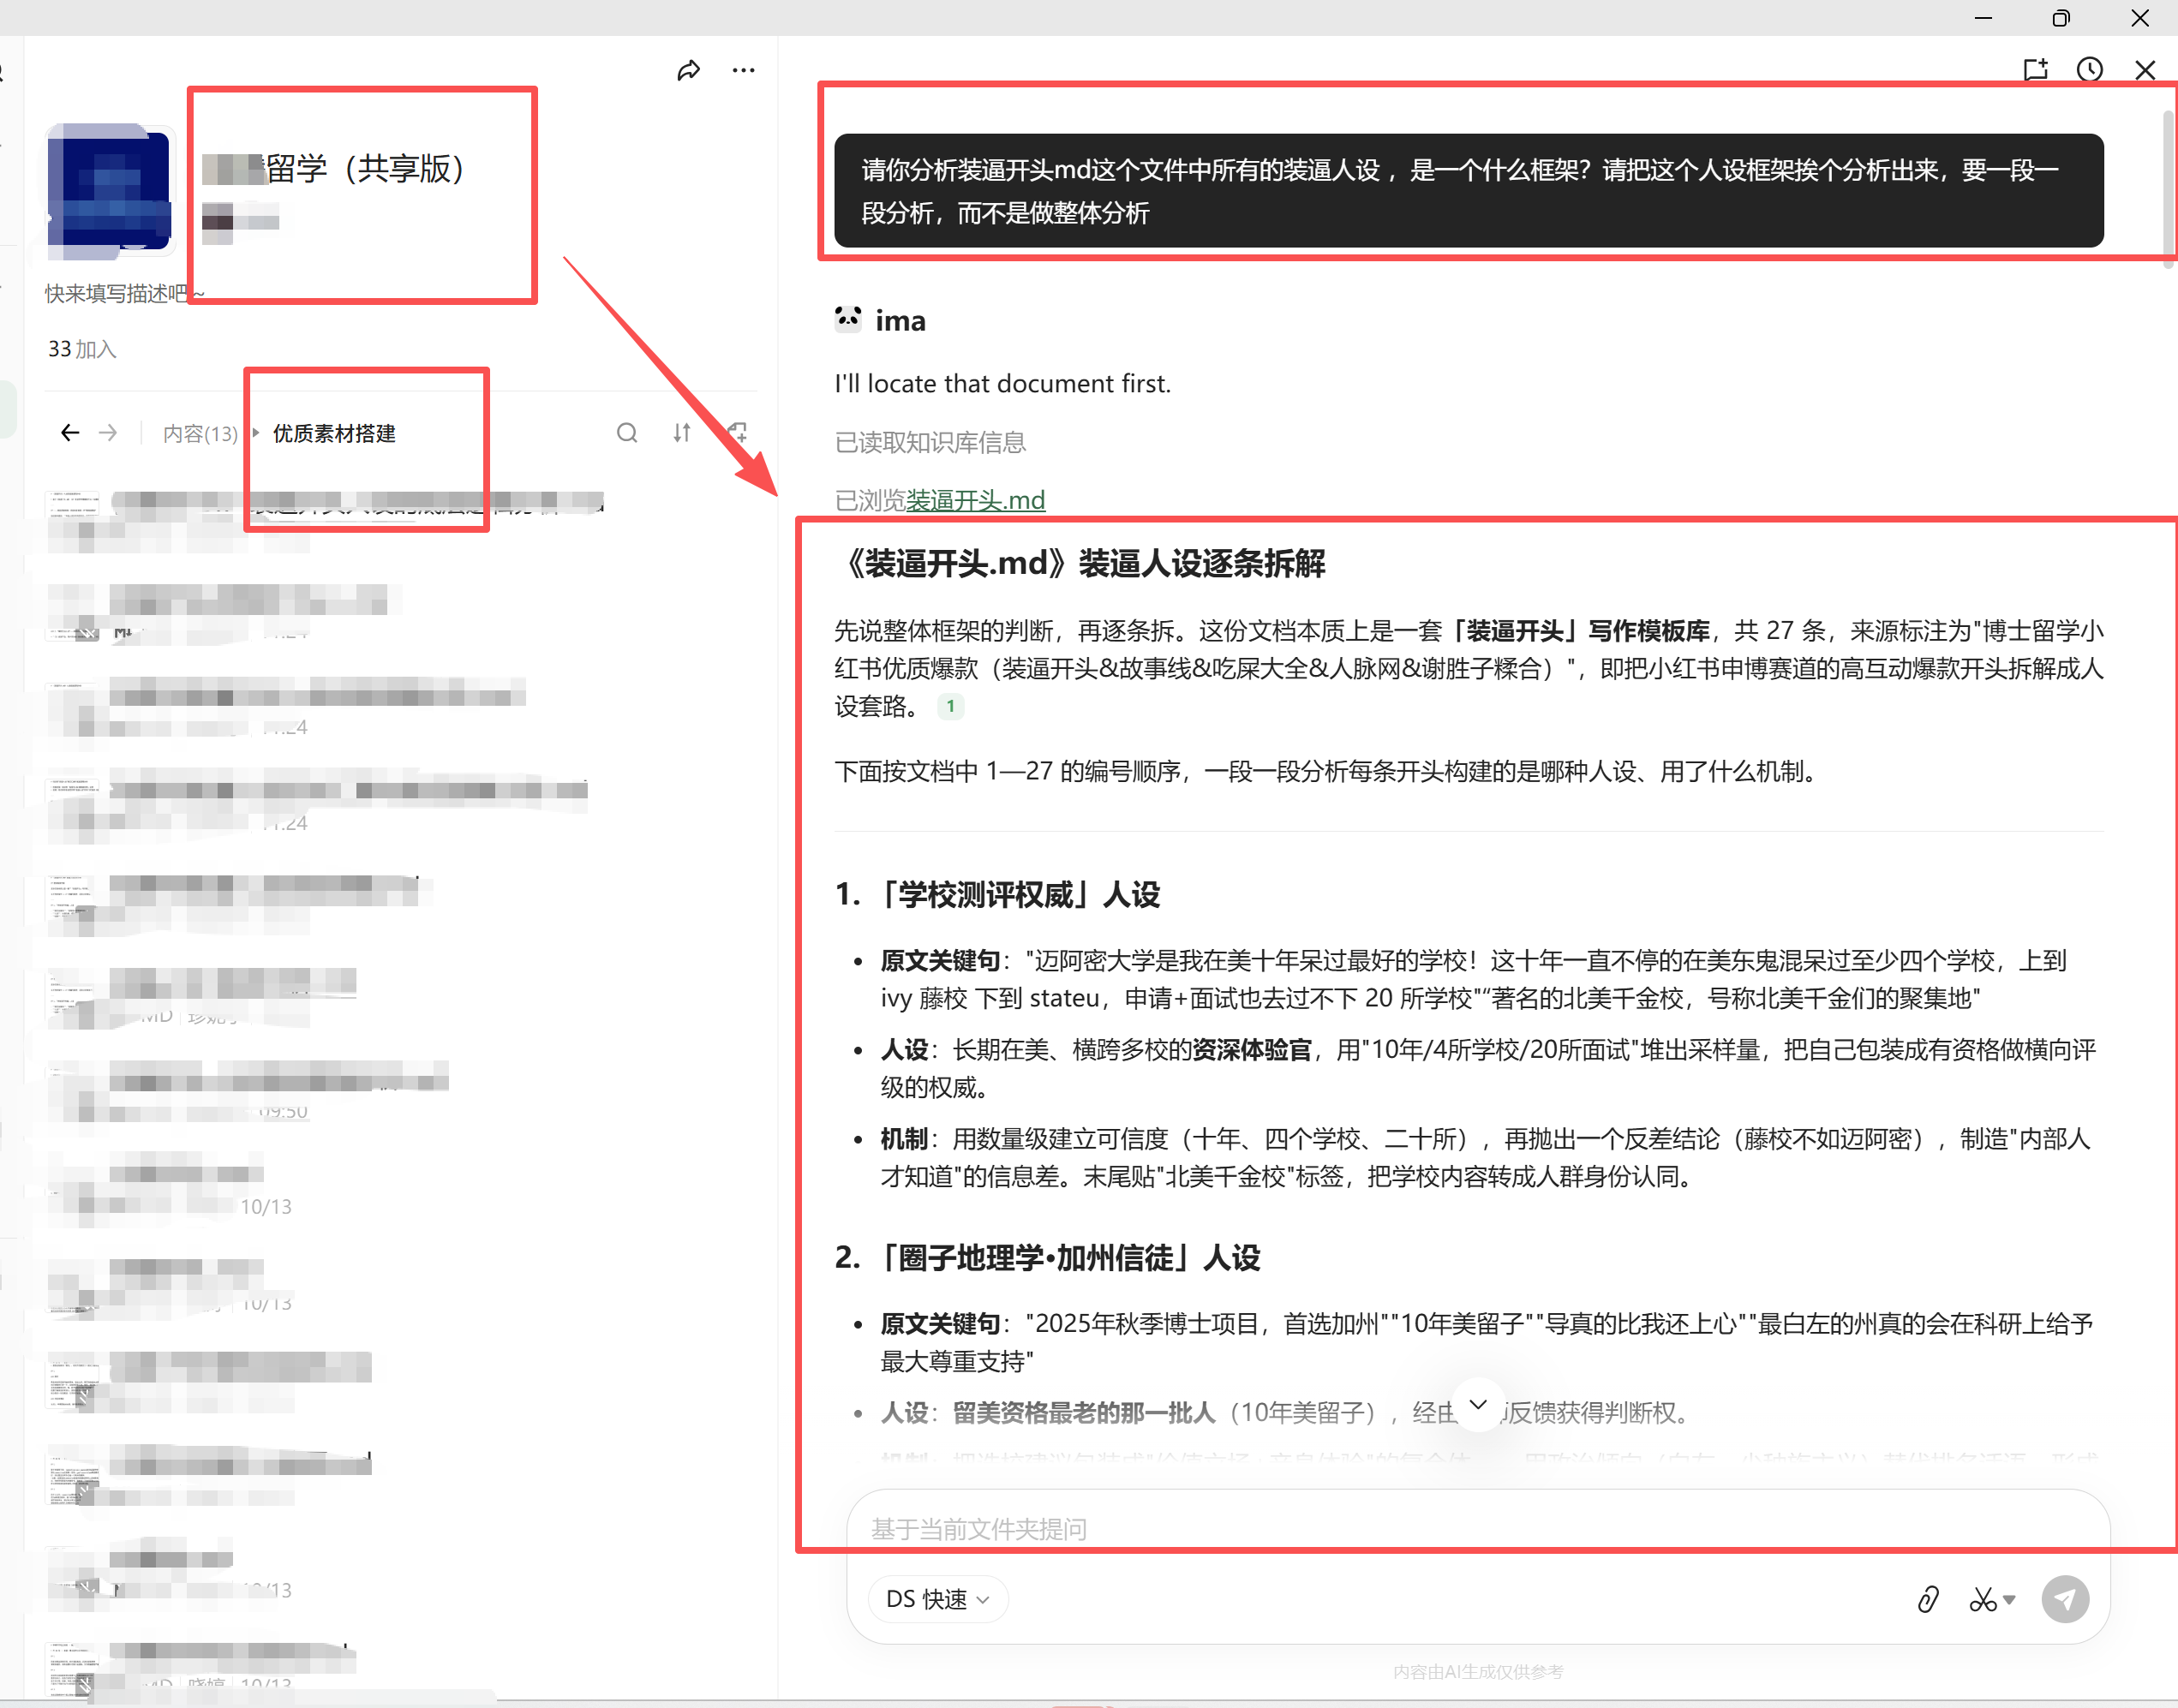
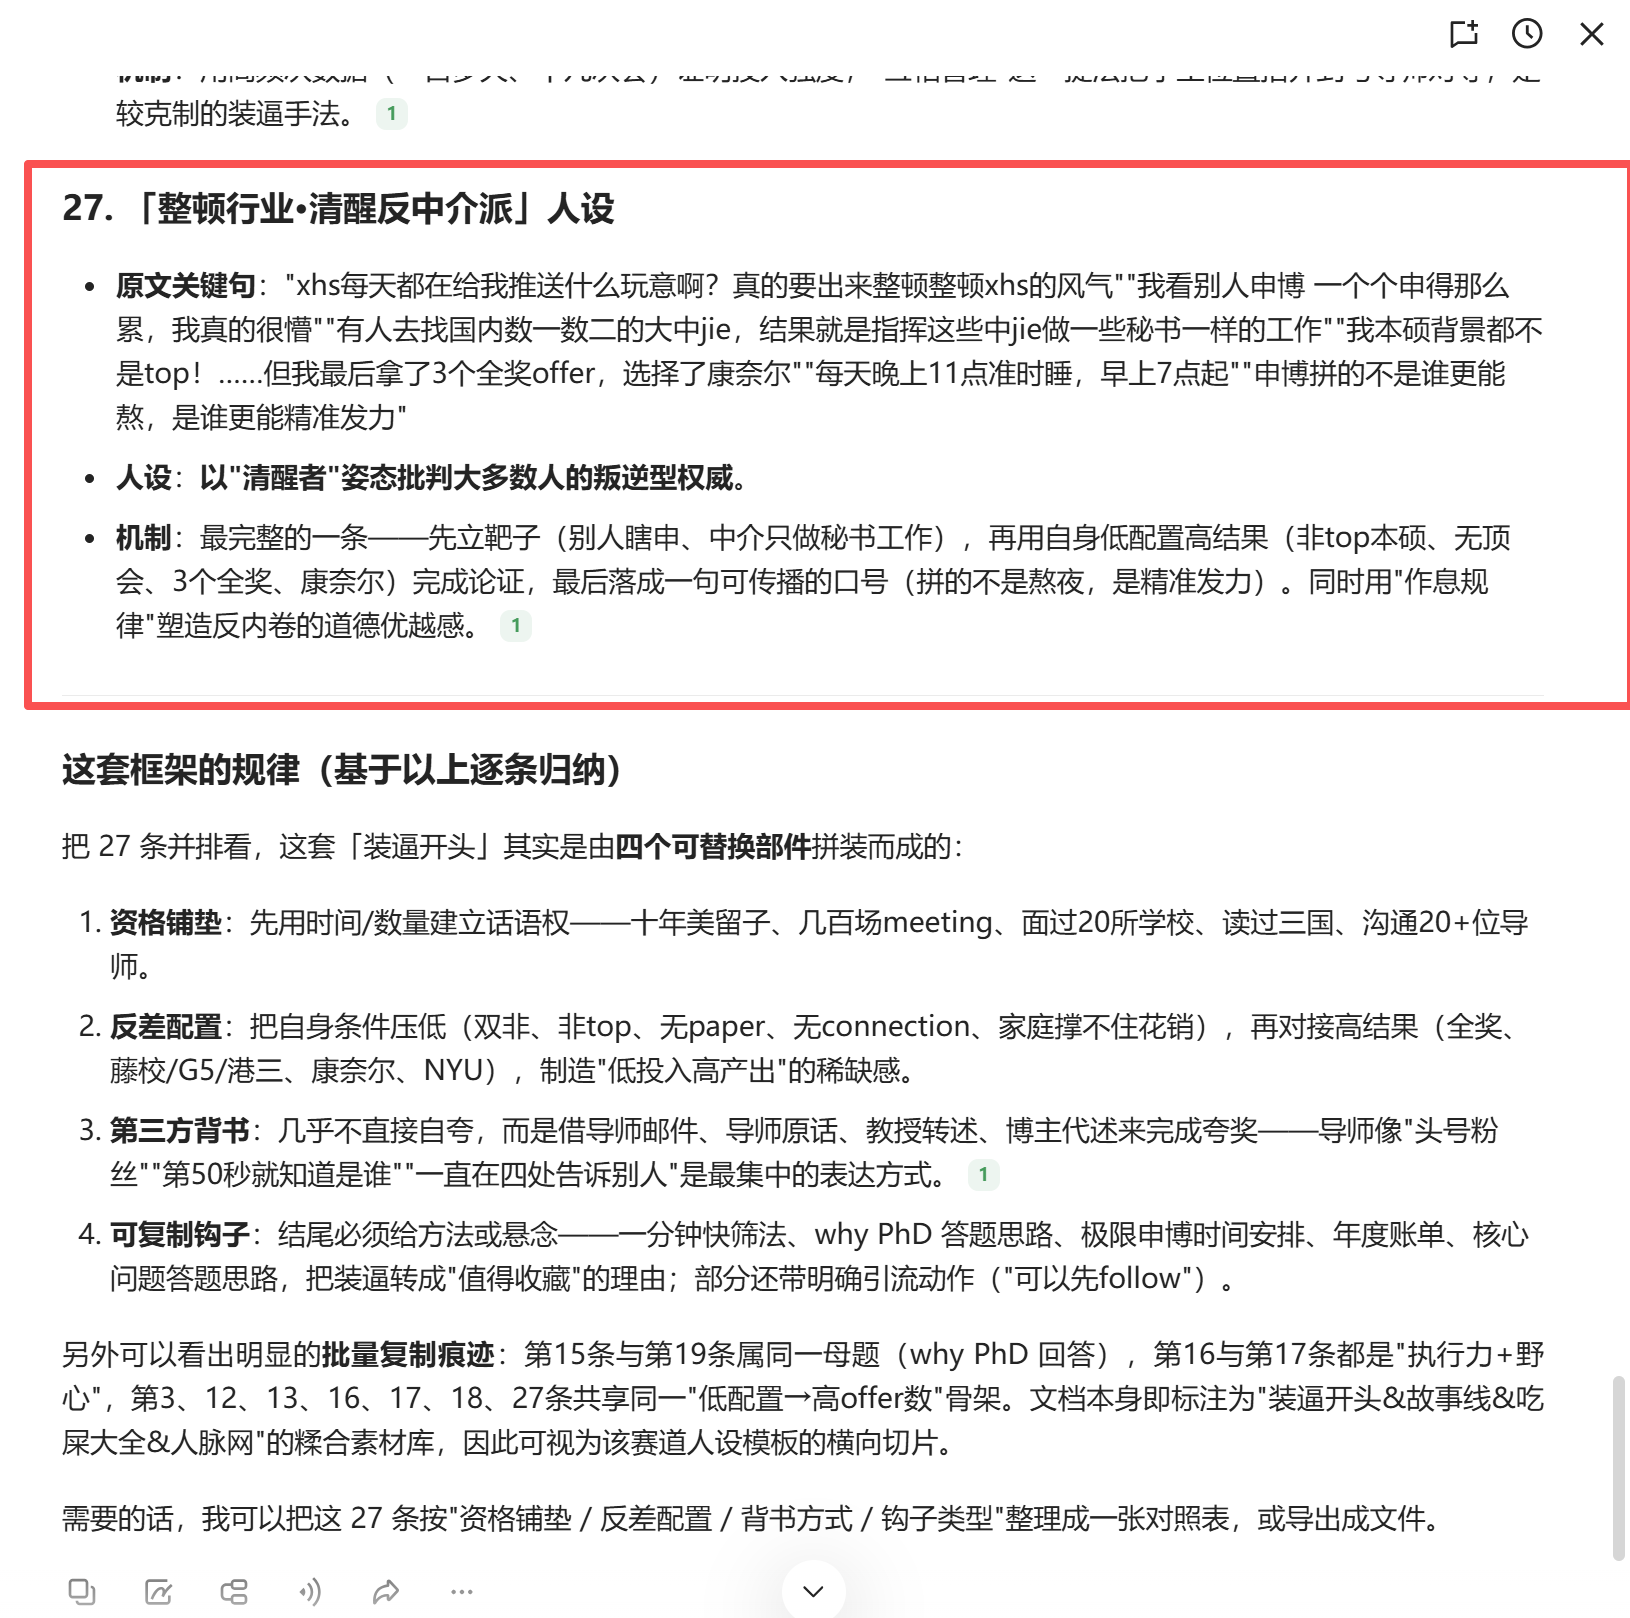
我的提示词是:
请你分析装逼开头md这个文件中所有的装逼人设 ,是一个什么框架?请把这个人设框架挨个分析出来,要一段一段分析,而不是做整体分析 |
以上内容,是在我们【内部已有的知识库】里面分析的,这样分析出来的东西会更好一点。
这种情况下,我再让AI生成一个MD文档给我。
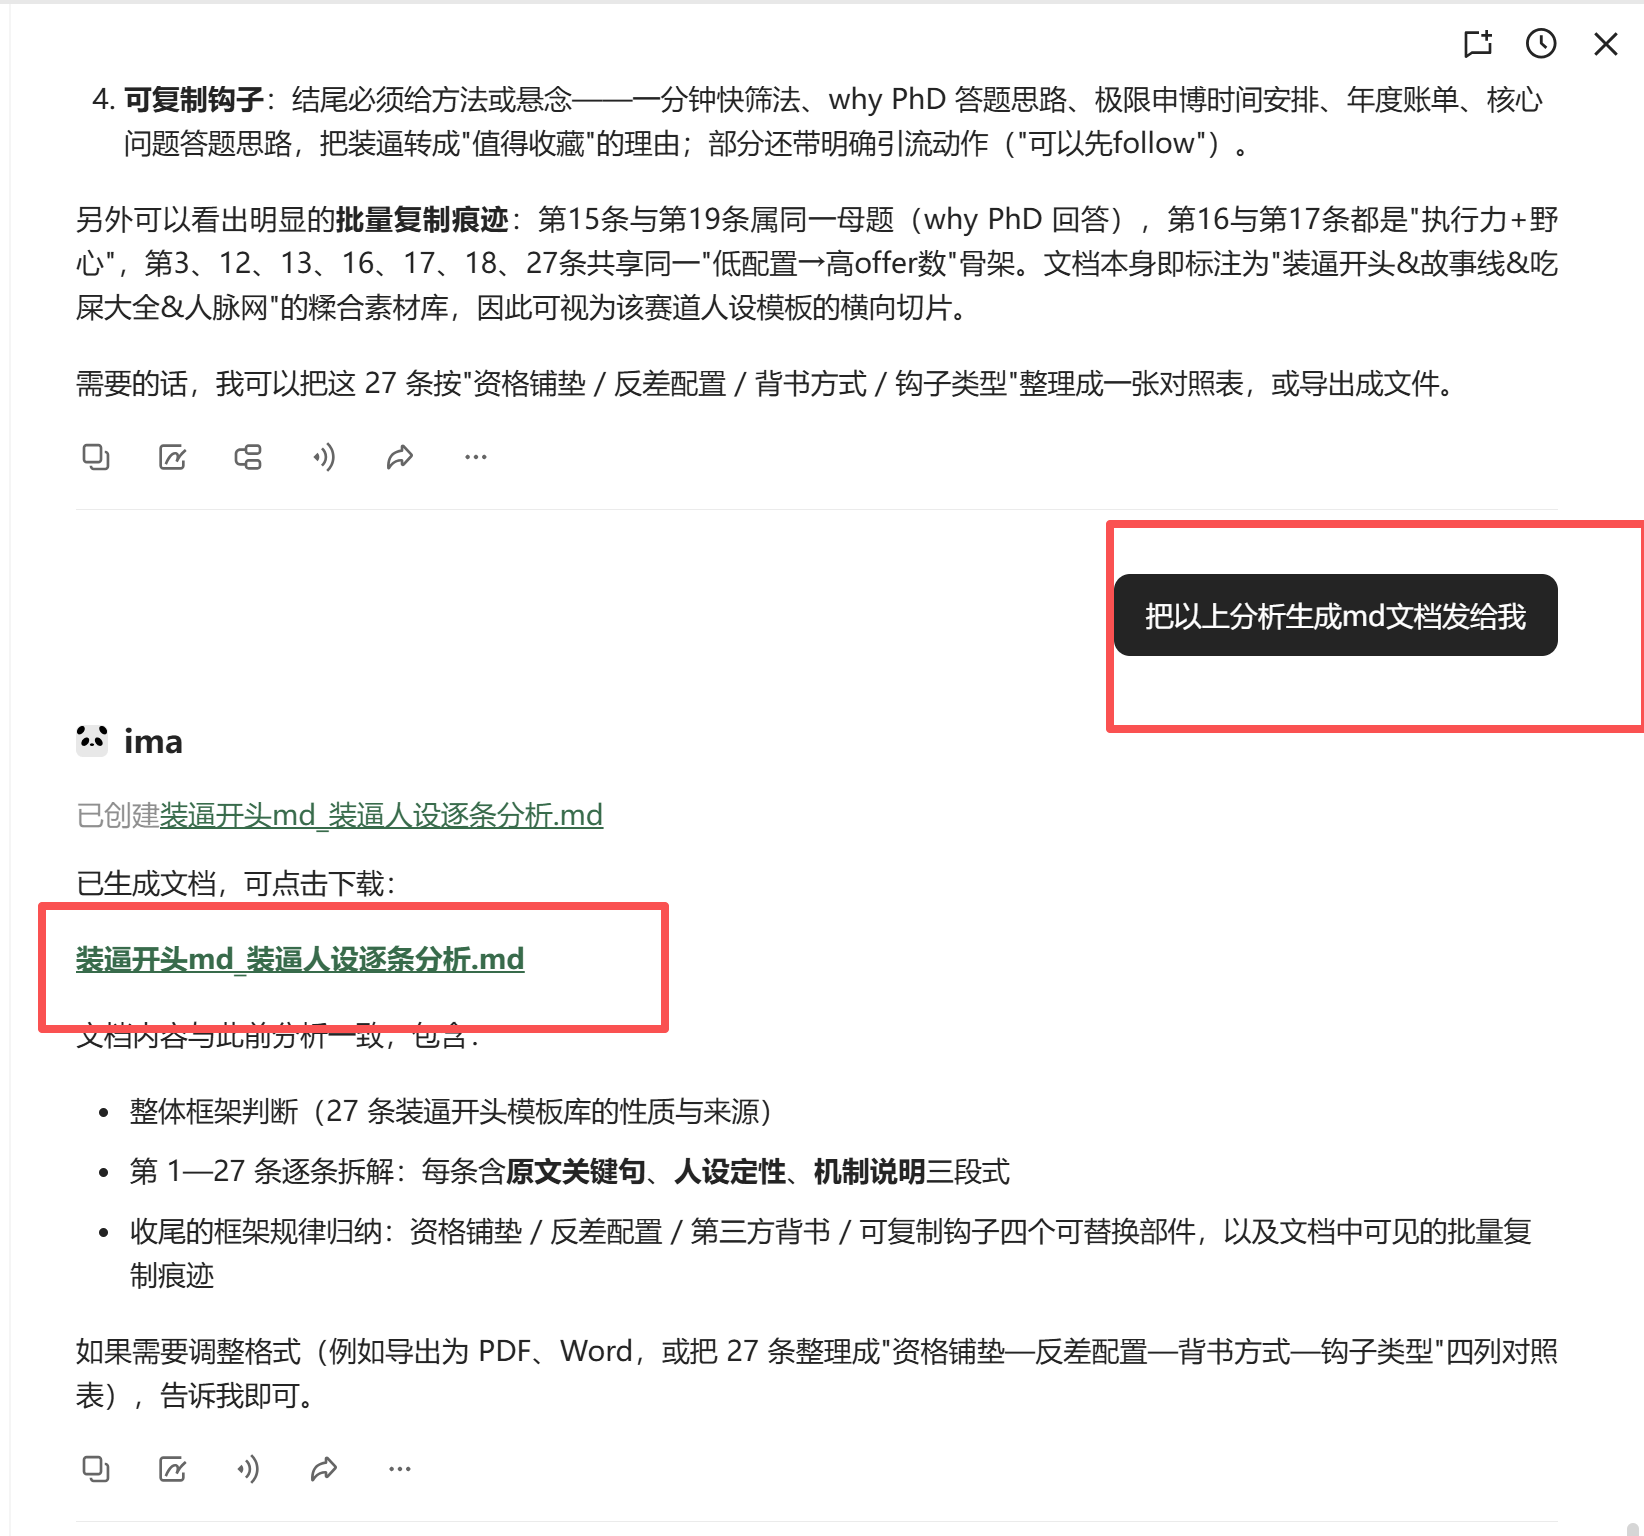
拿到这个MD文档之后,
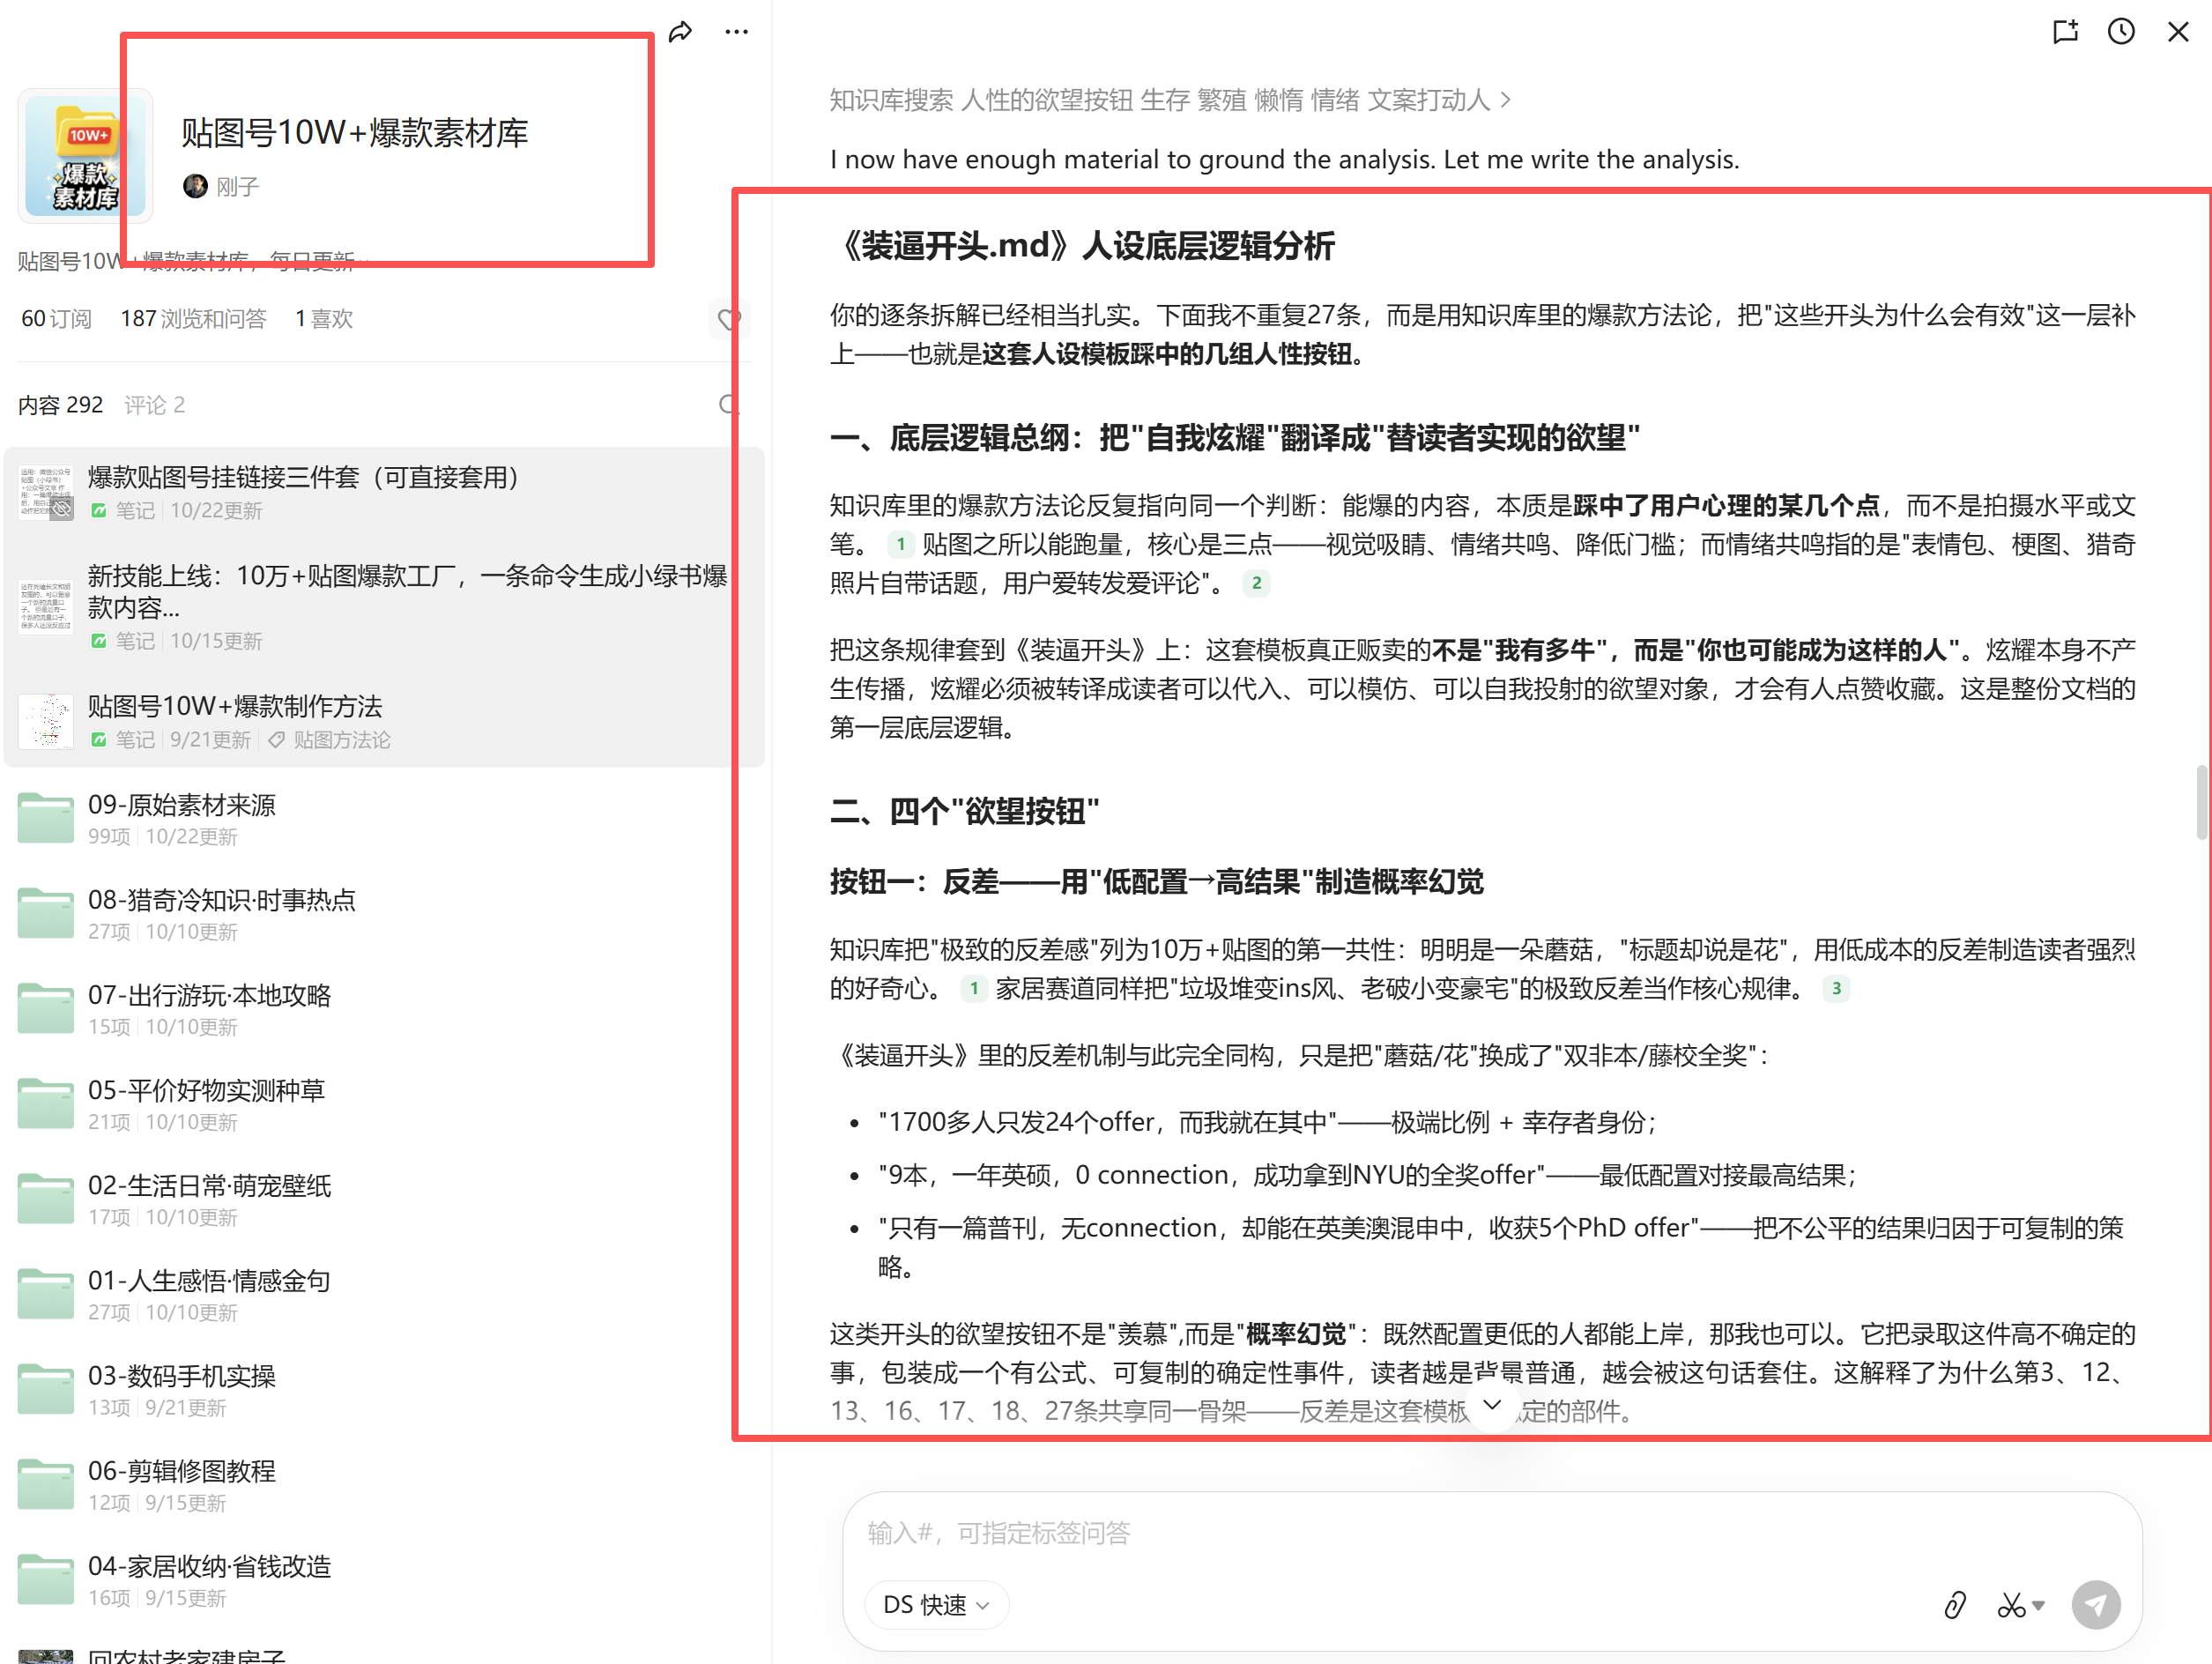
我再跑到公用的知识库里面,也就是贴图号的那个知识库里面,复制粘贴我刚刚生成的东西,
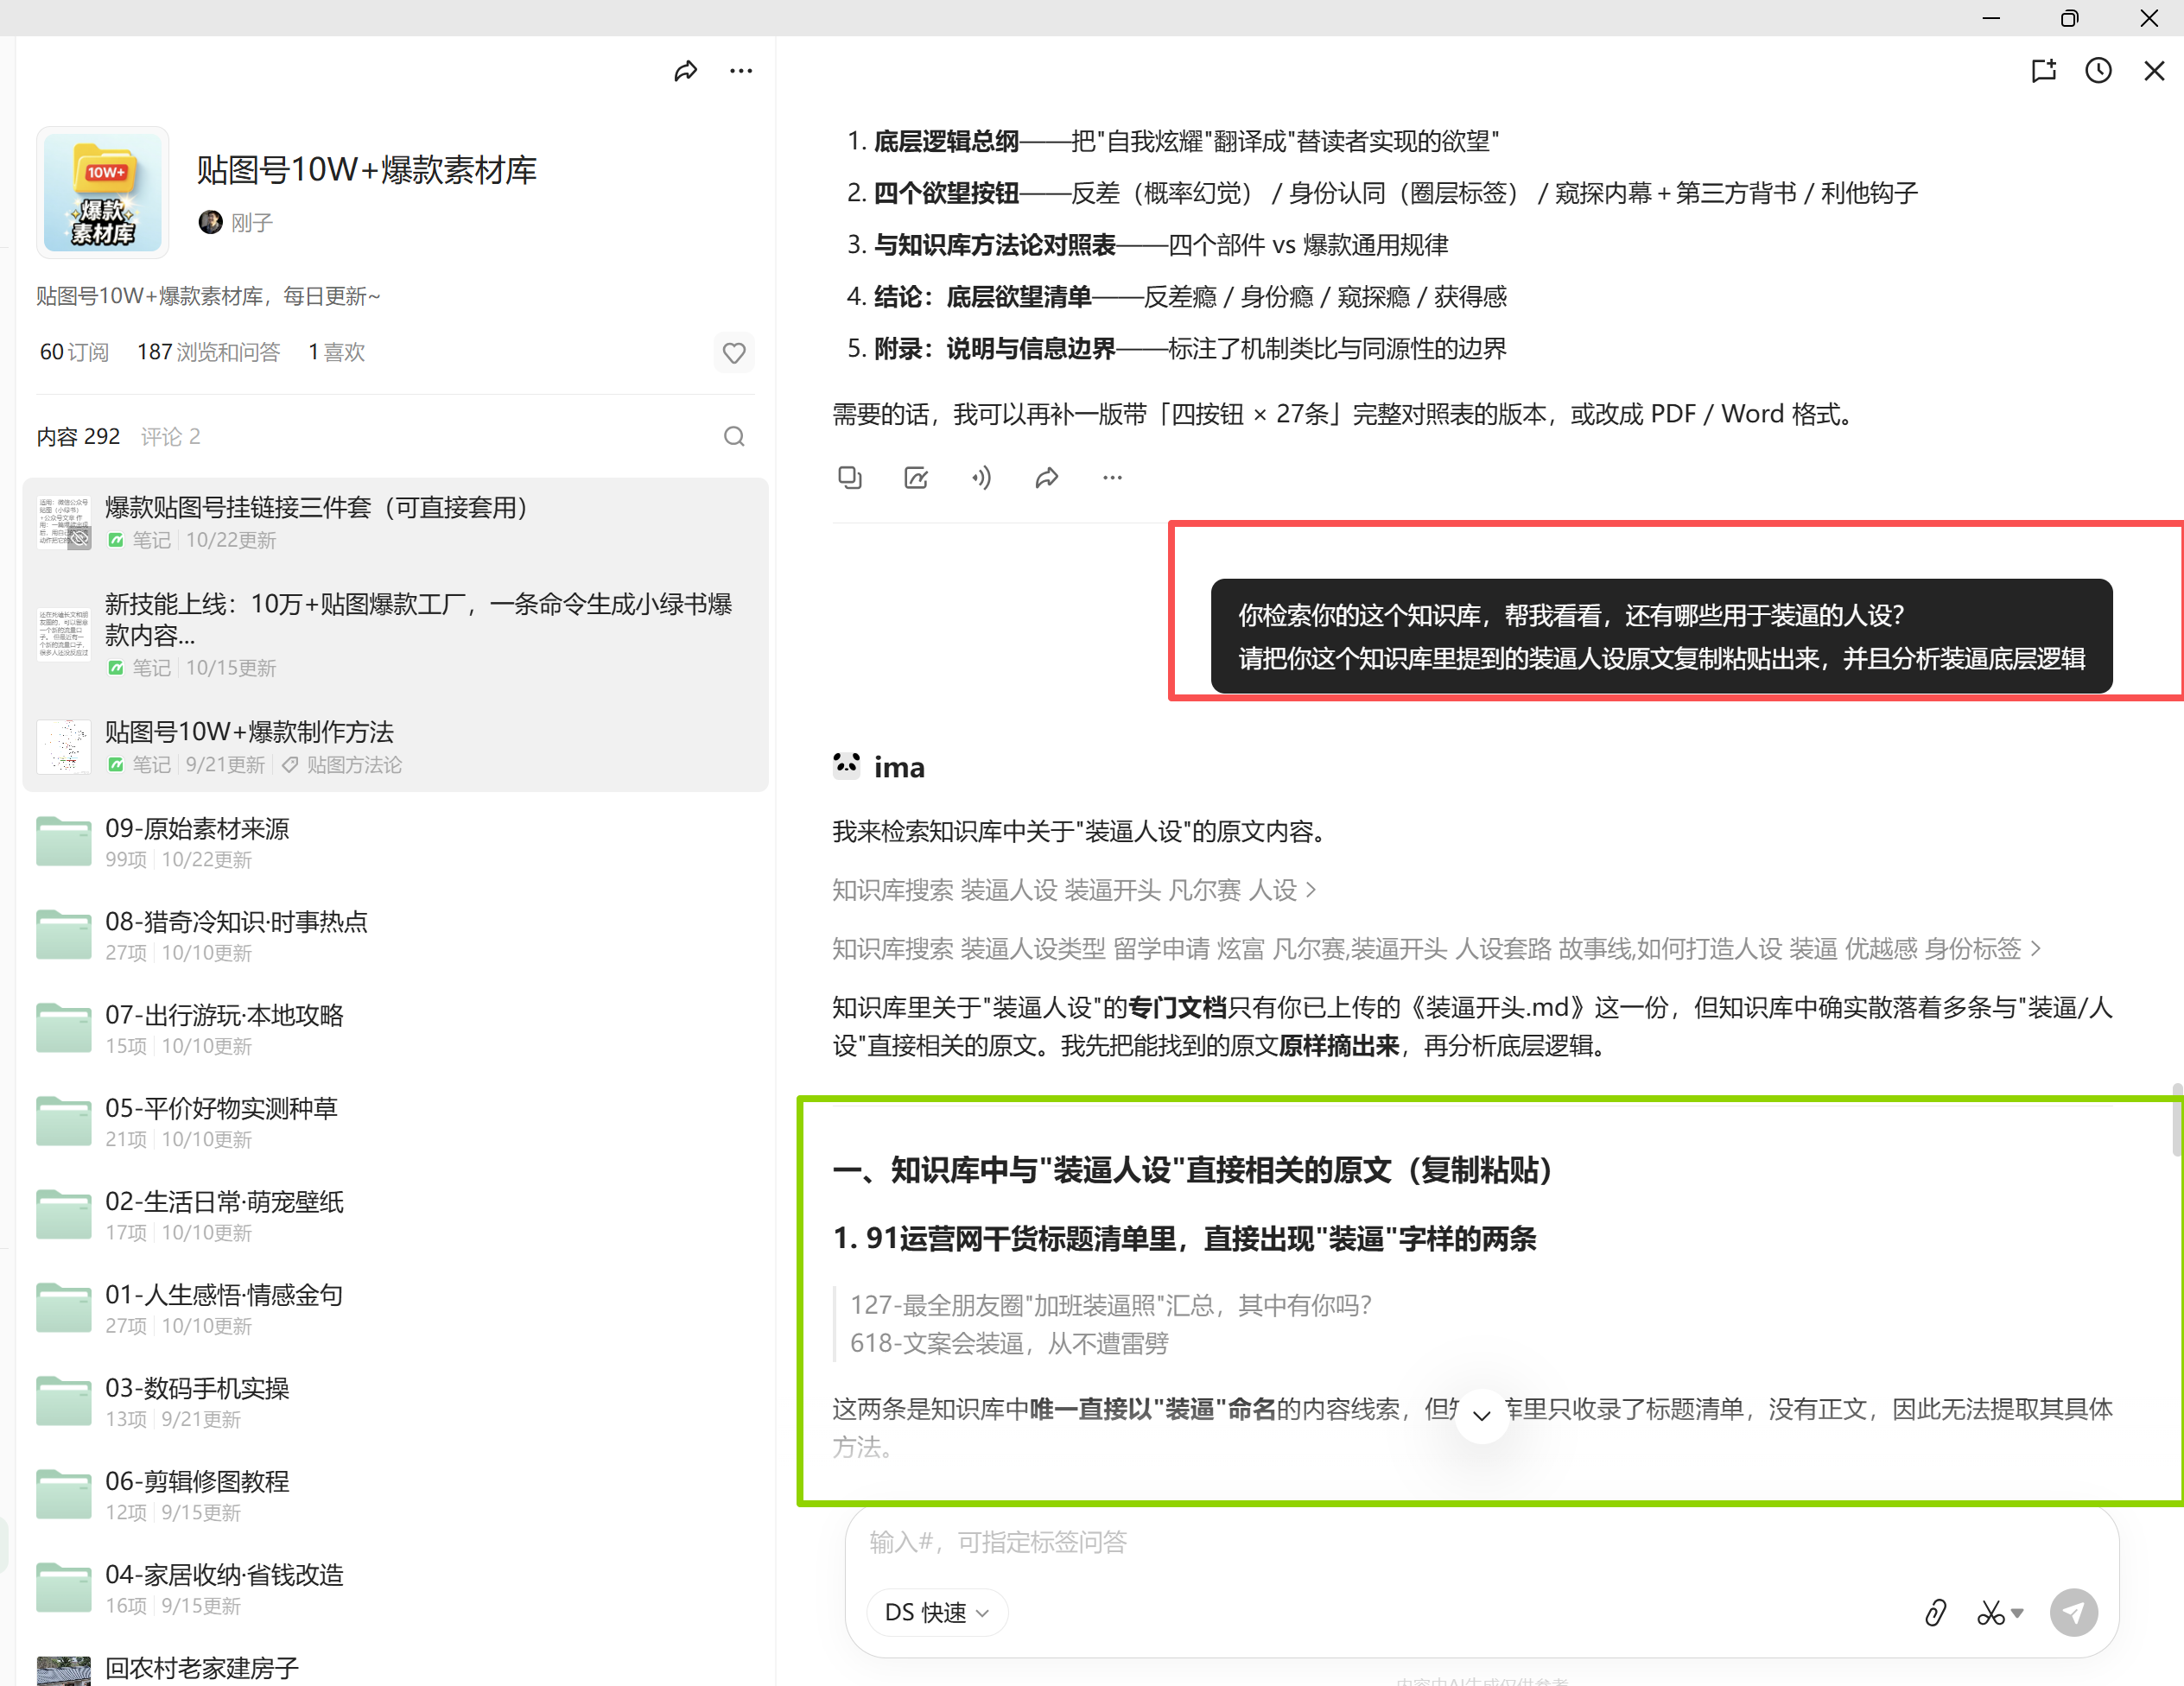
然后去问AI:这个装逼开头文件里面,人设的底层逻辑是什么?
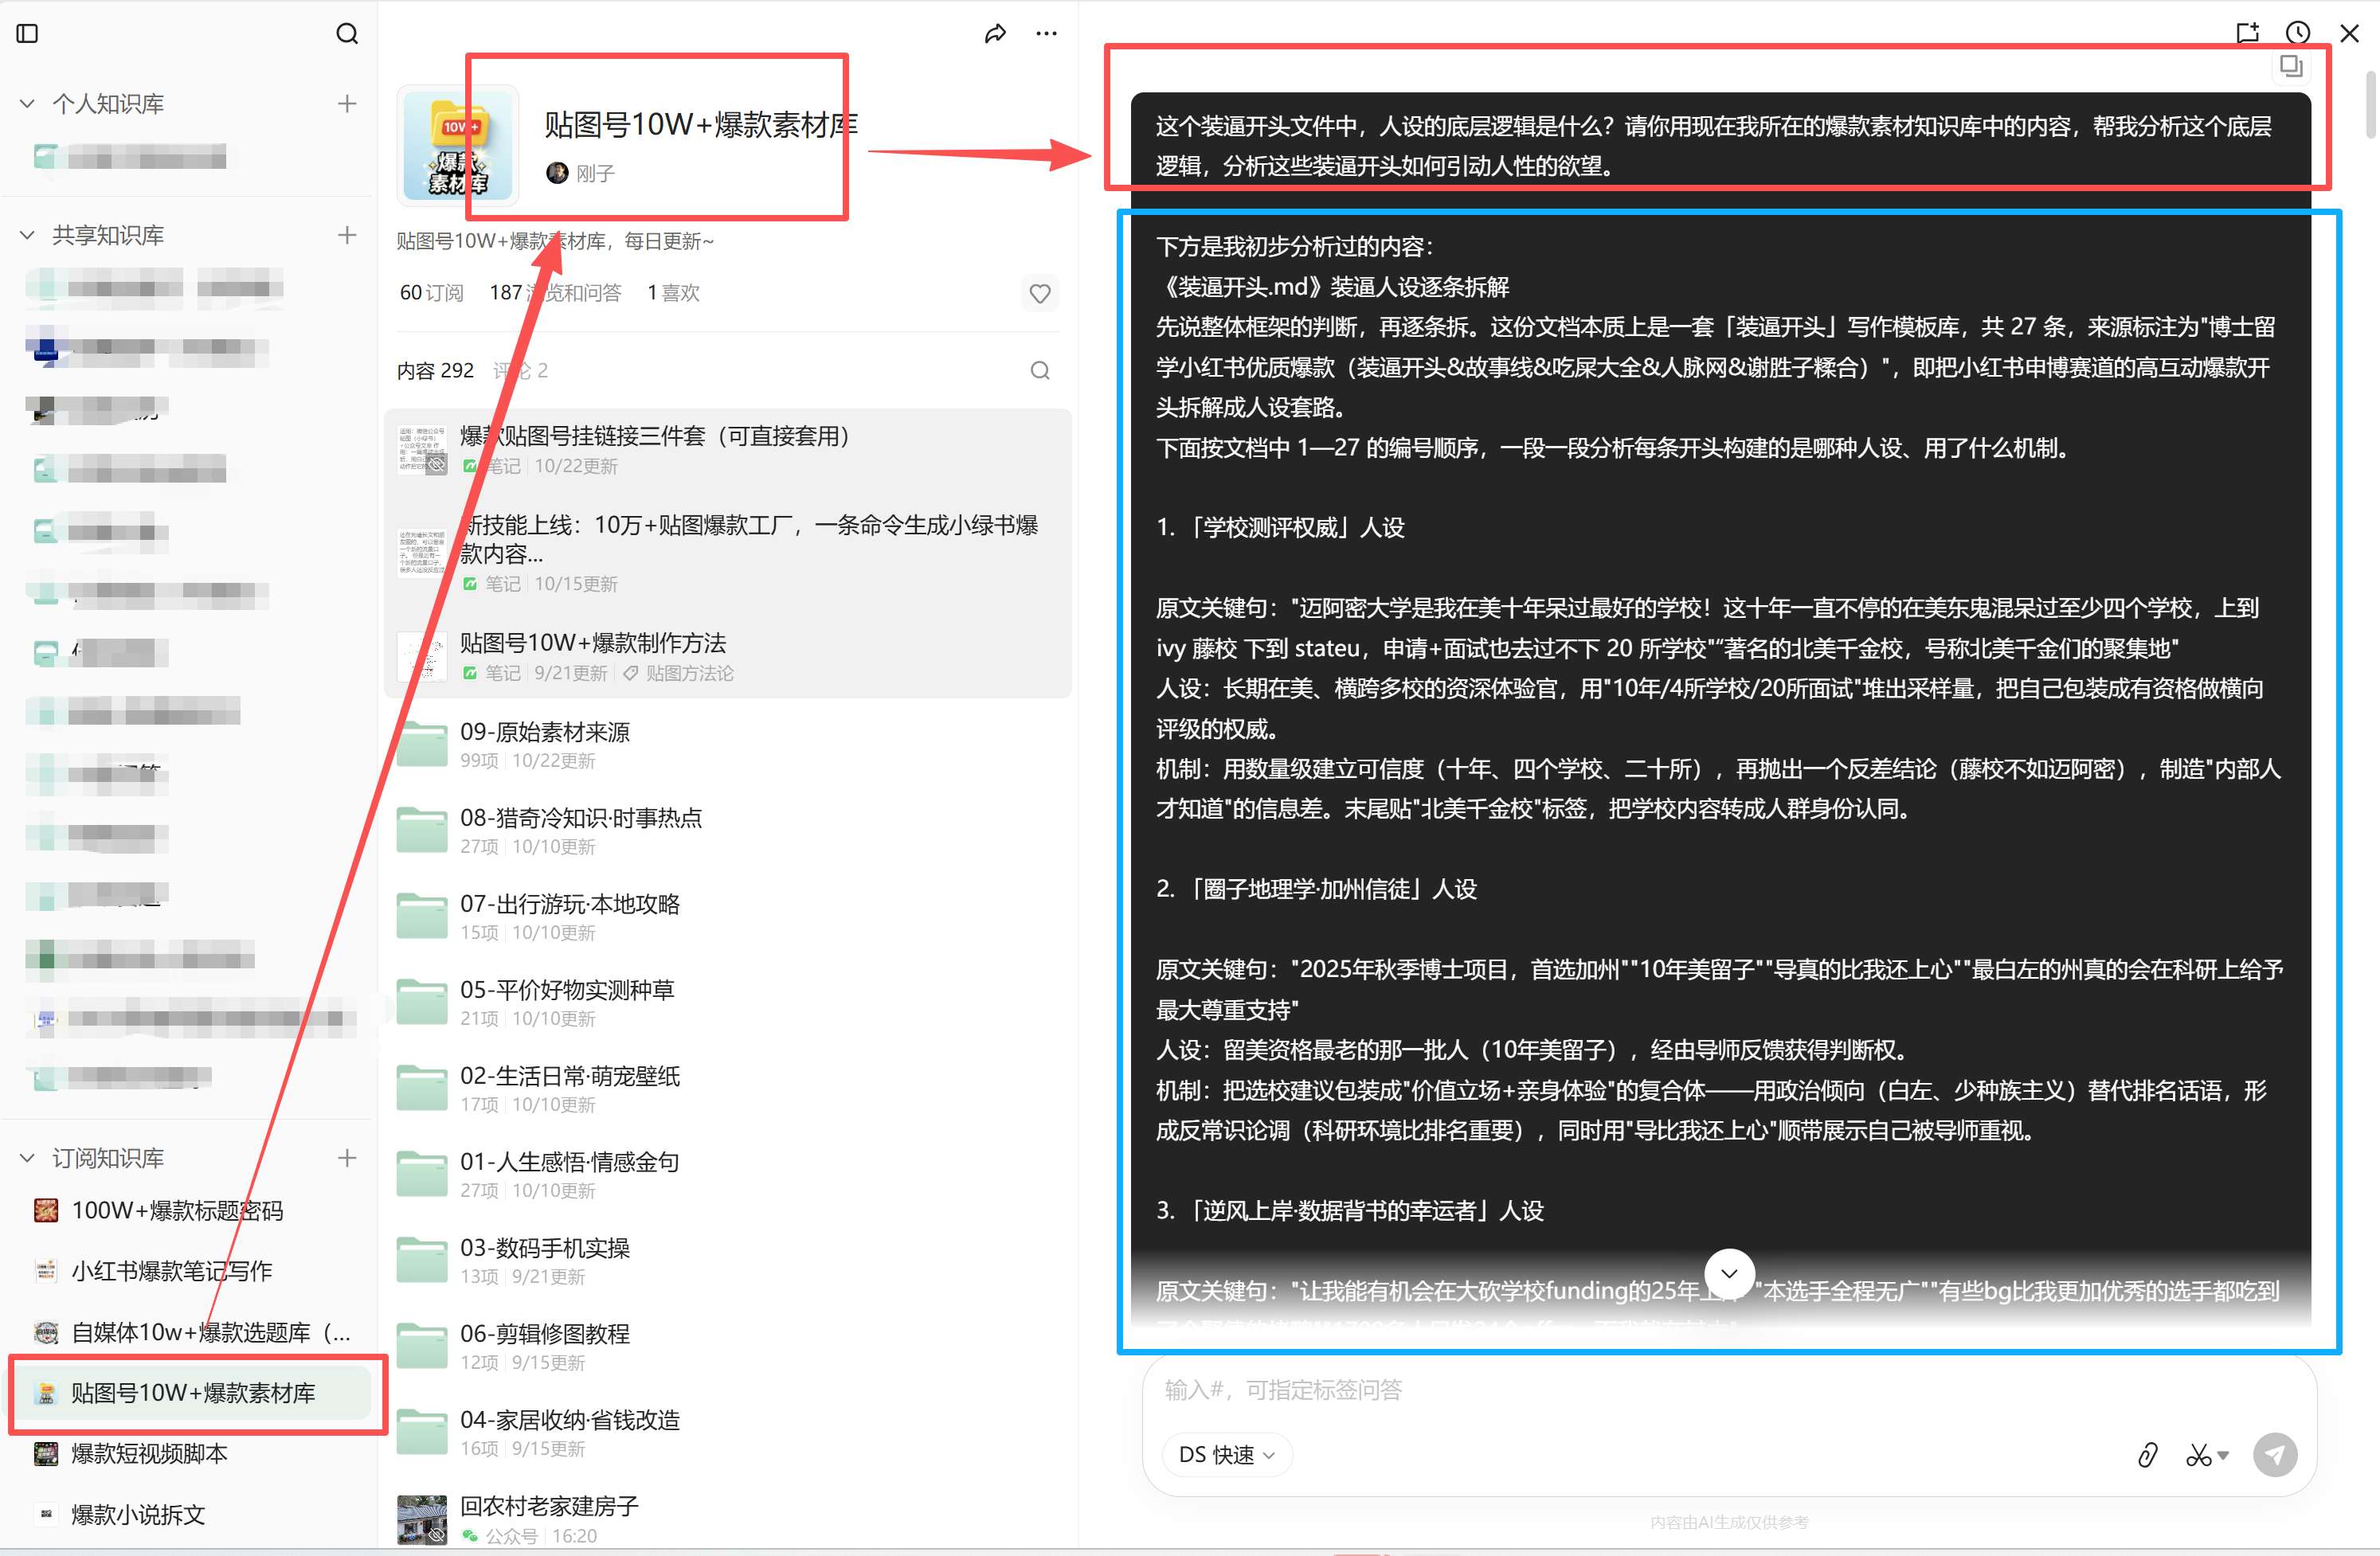
如上图,红圈的提示词是我写的,蓝圈的内容是复制粘贴的。
蓝圈的内容就是在上一步骤中生成的红圈内容。
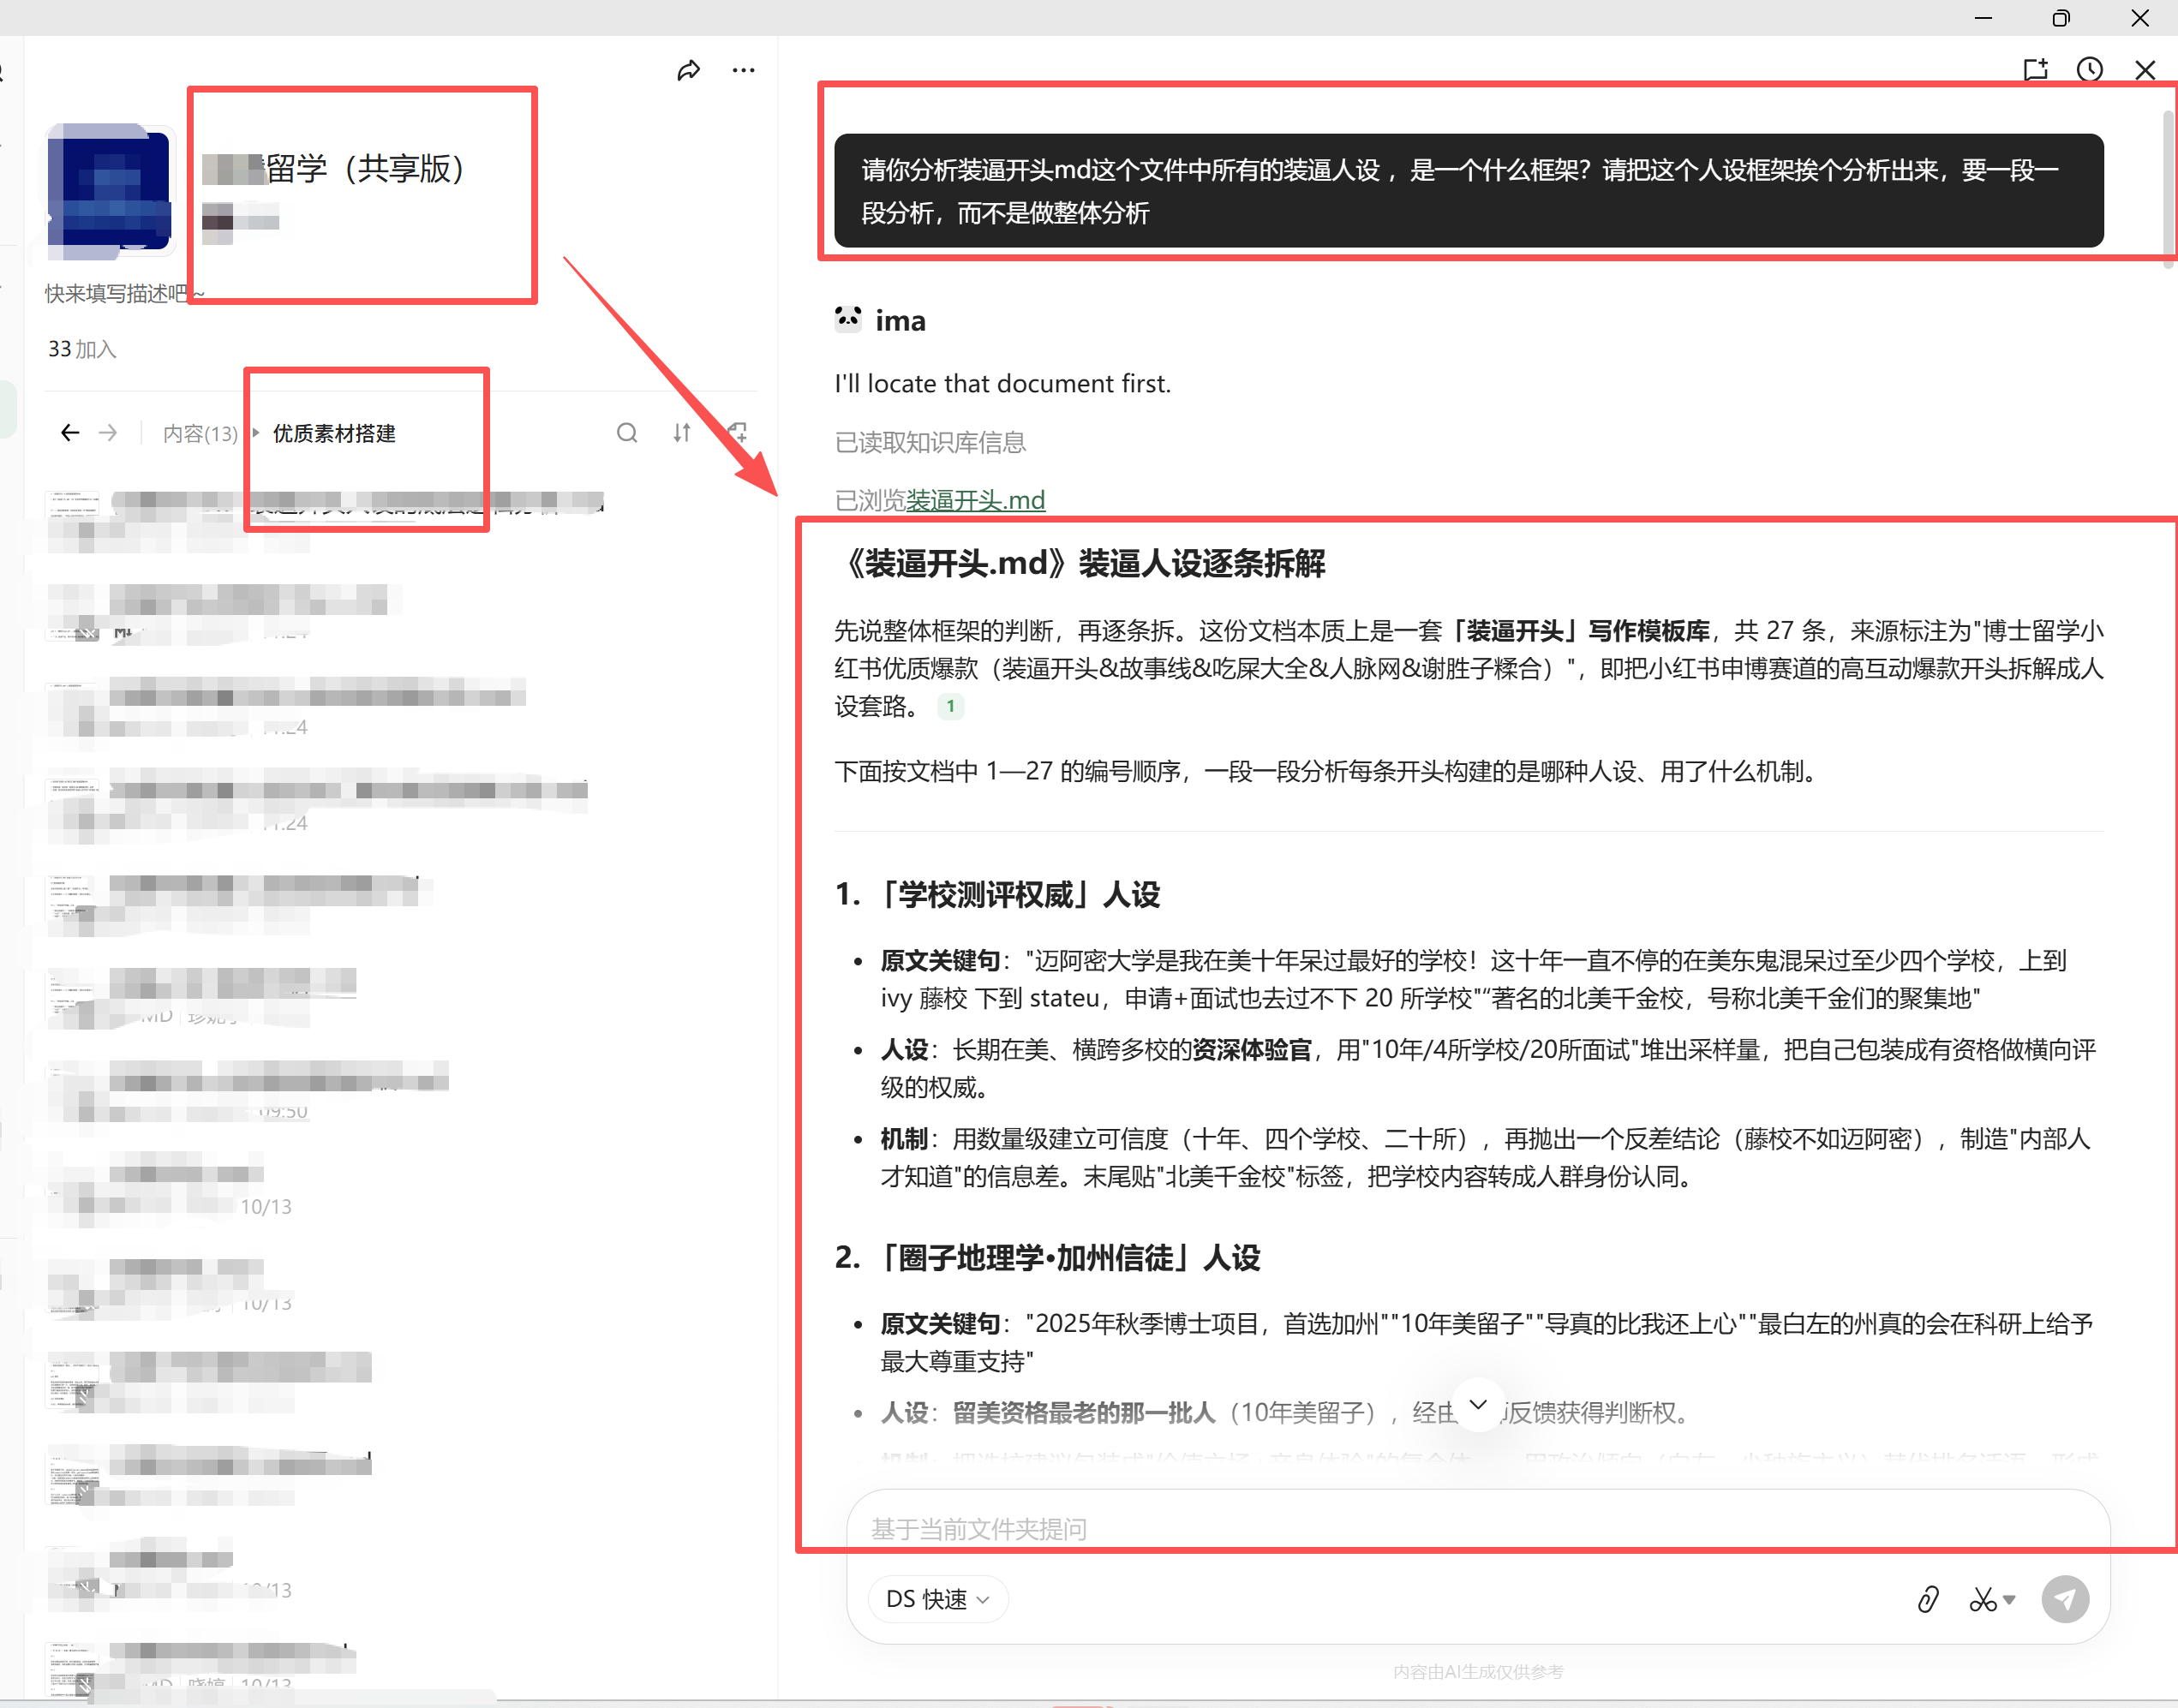
可以观察到,
珍妮在用这种【公用的外部知识库】,
去分析【我们内部知识库里面的装逼开头底层逻辑是什么】。
我为什么要这么做呢?
因为公用的外部知识库,本身就是10万+爆款素材库,
就相当于用一个大的、通用的、比较牛逼的盘子,
我去这个牛逼的盘子里投喂我自己细分赛道的内容,
就相当于把自己细分赛道的内容,拉过去“检阅&阅兵”一样的感觉。
这样做的目的,
就类似于:
让一个体zhi内的高官,来检查【体制外私企的民营营业,是否合法合规】一个感觉。
高层分析出来的视角,一定是不一样的。
用这个办法,
去分析我们内部这个装逼开头的逻辑,
那它可能能分析出一些新鲜东西出来。
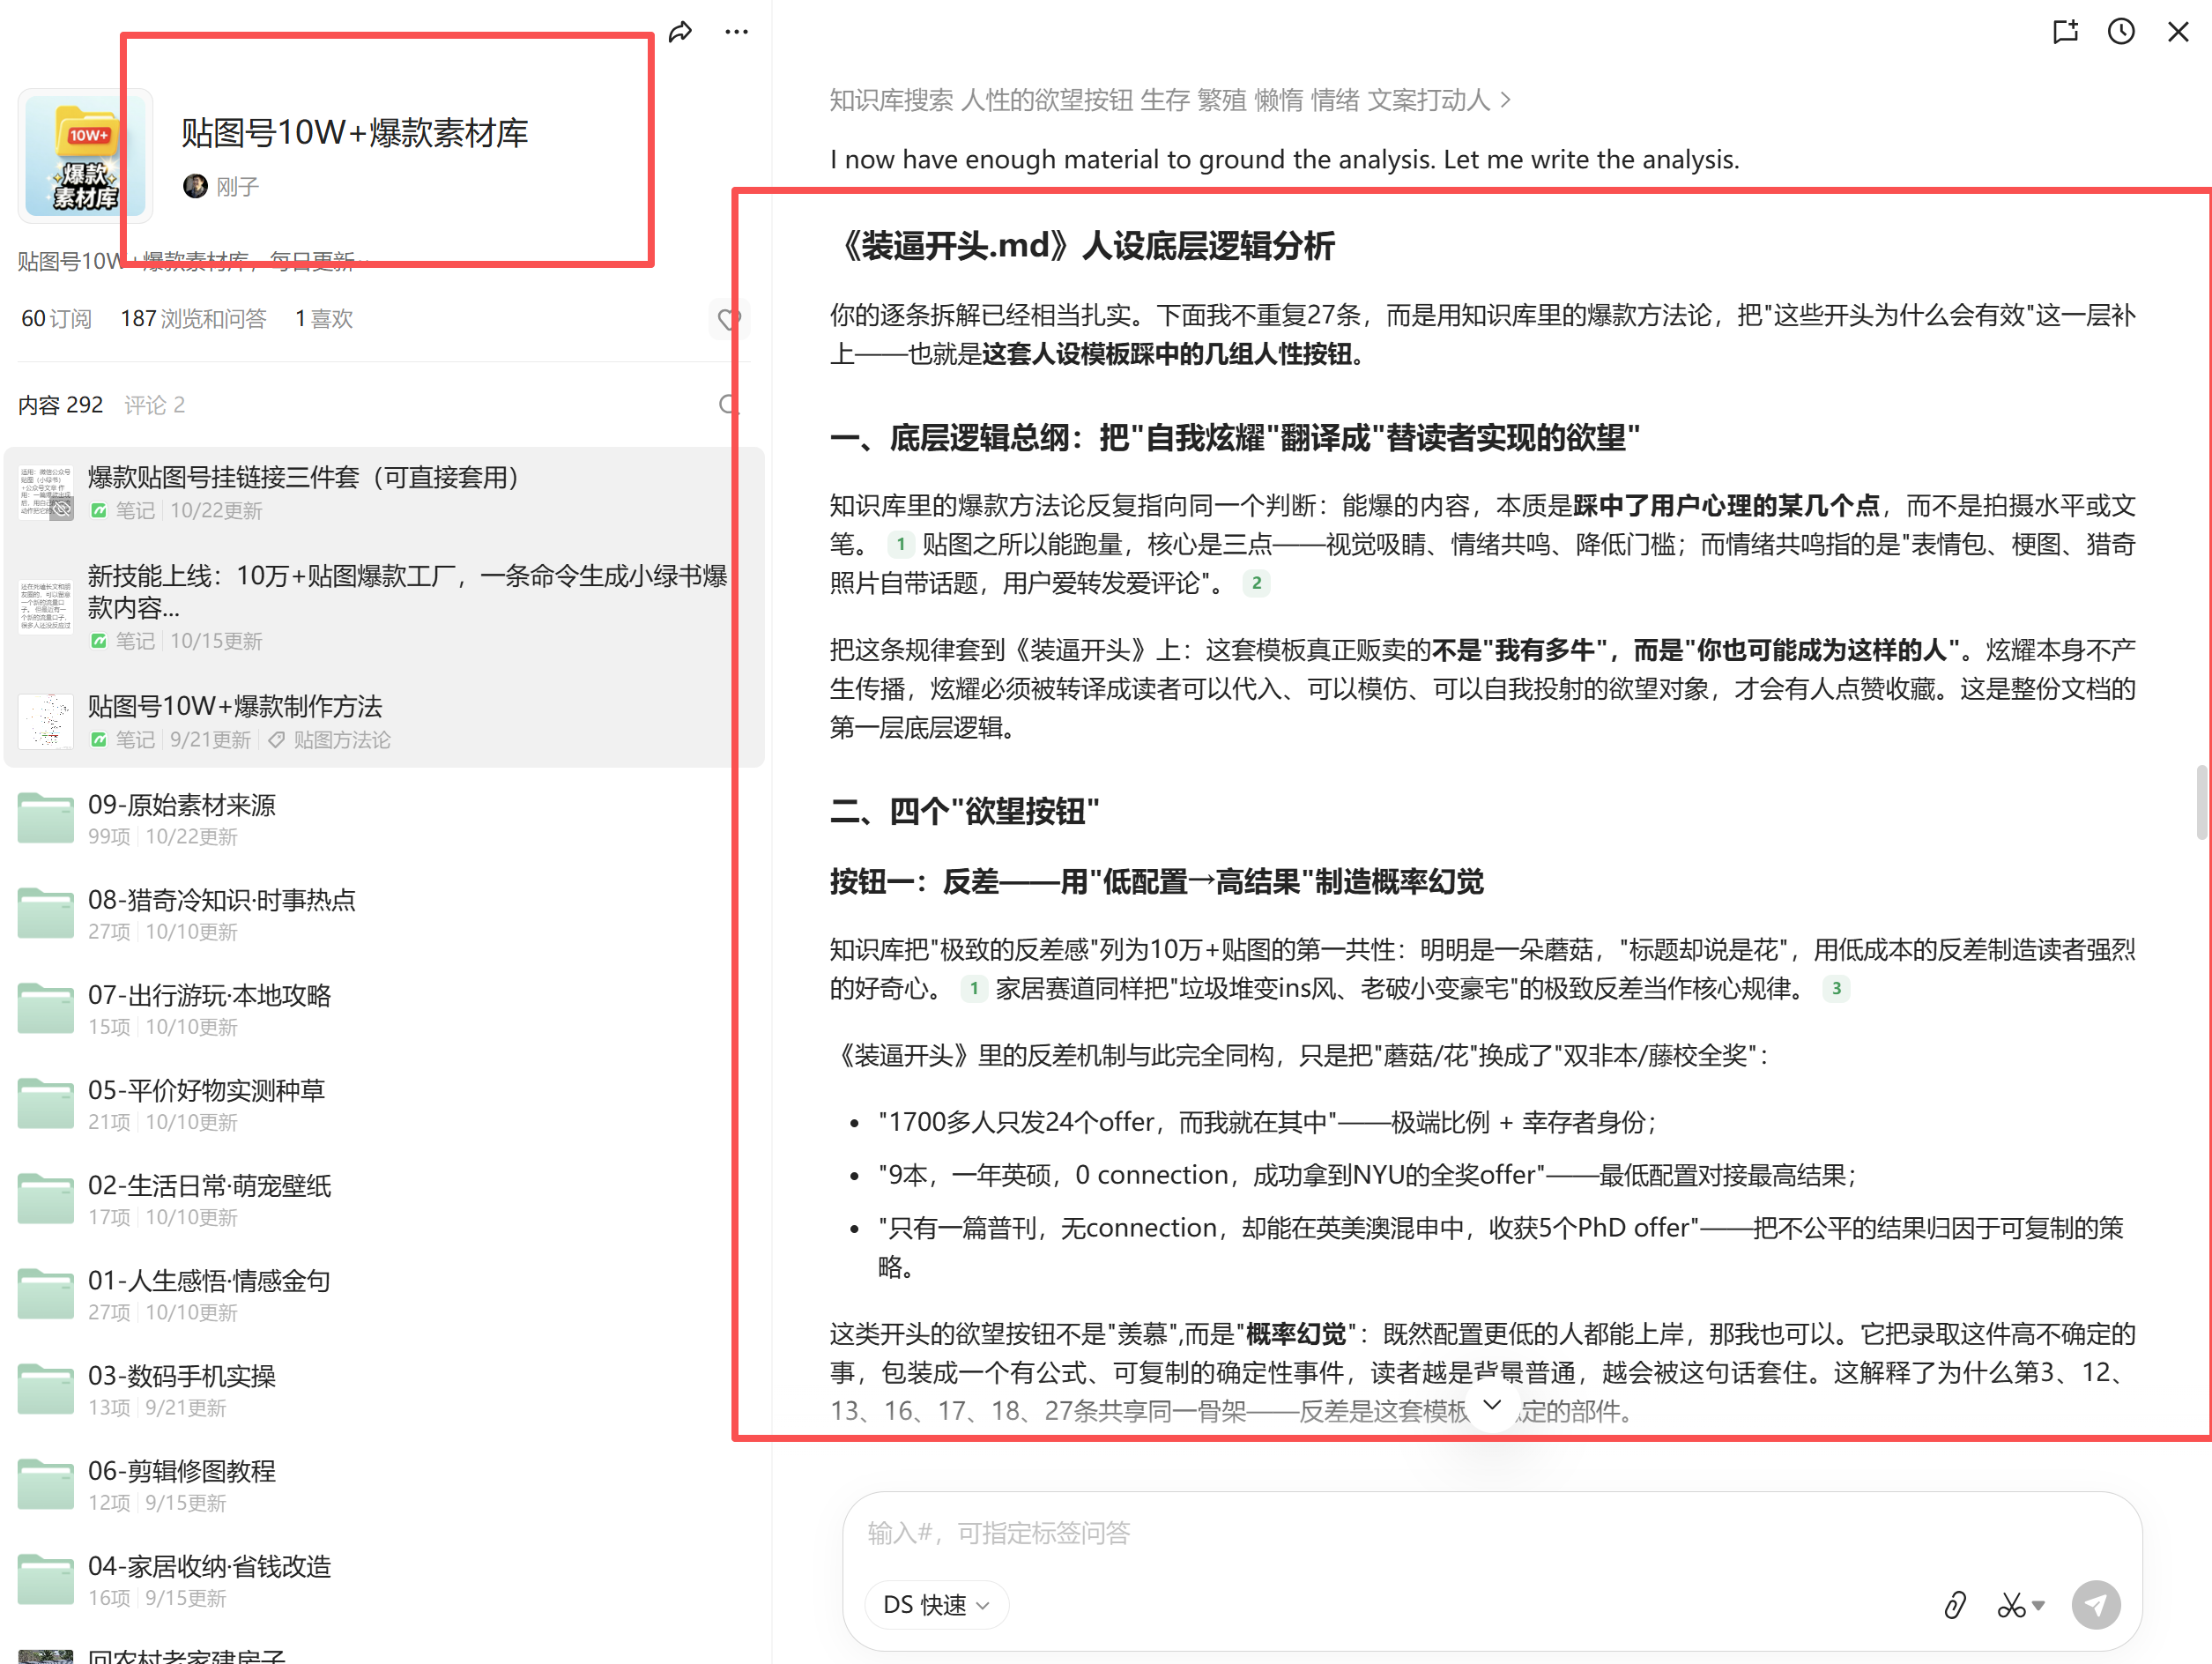
AI果然生成出来了一些东西,
那么这相当于“体制内高官,把自己评估【哪个企业是优秀企业的评分标准】,直接告诉我们了”。
所以,此时,我就让AI把生成的东西整理成一个md文档。
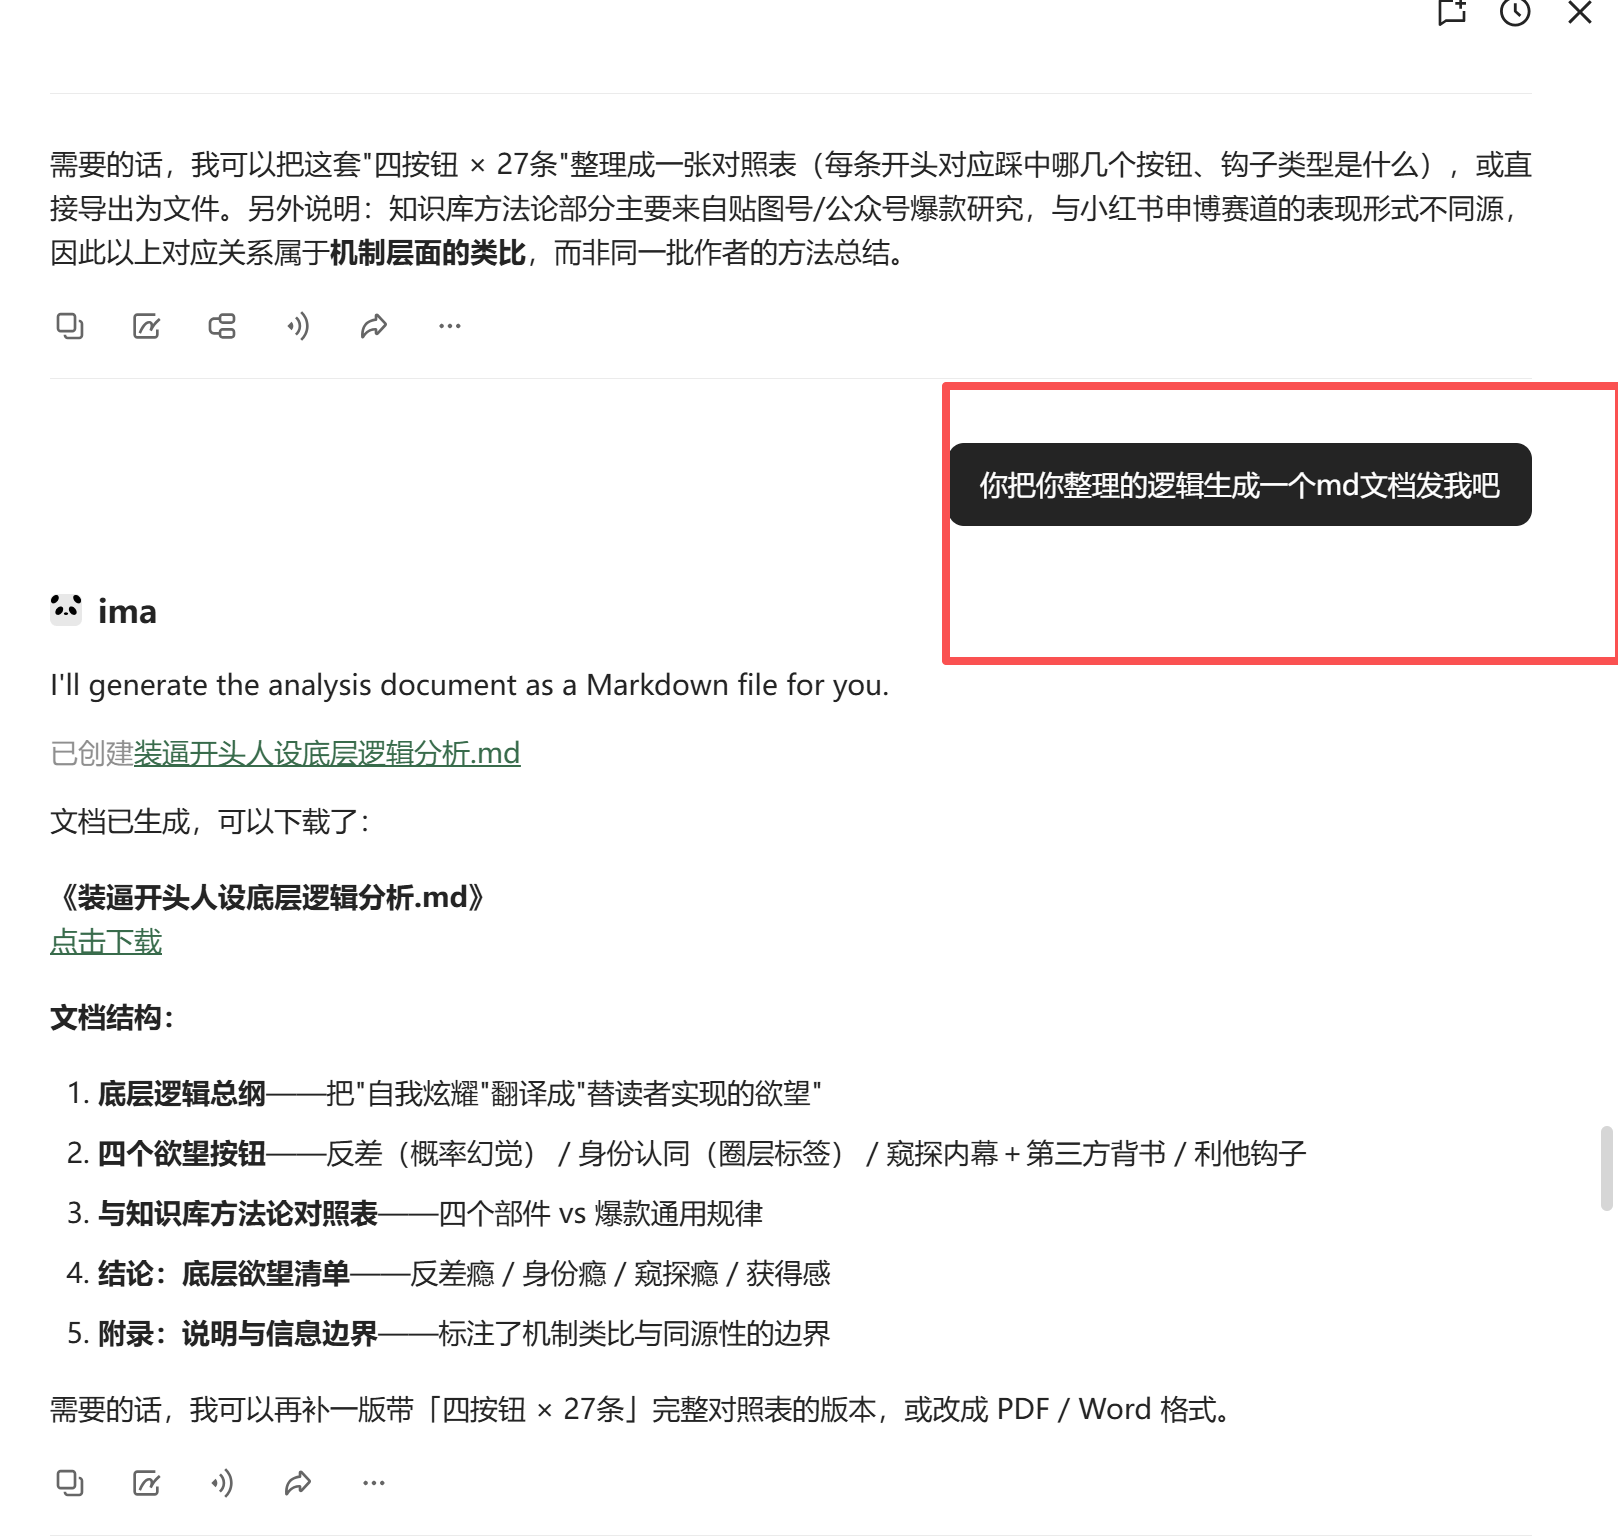
这样做的目的是,
但是接下来我就会跟它说:
“那你检索你这个知识库,帮我看一下还有哪些用于装逼的人设?你把你提到的这个装逼人设原文复制粘贴出来,分析装逼底层逻辑。”
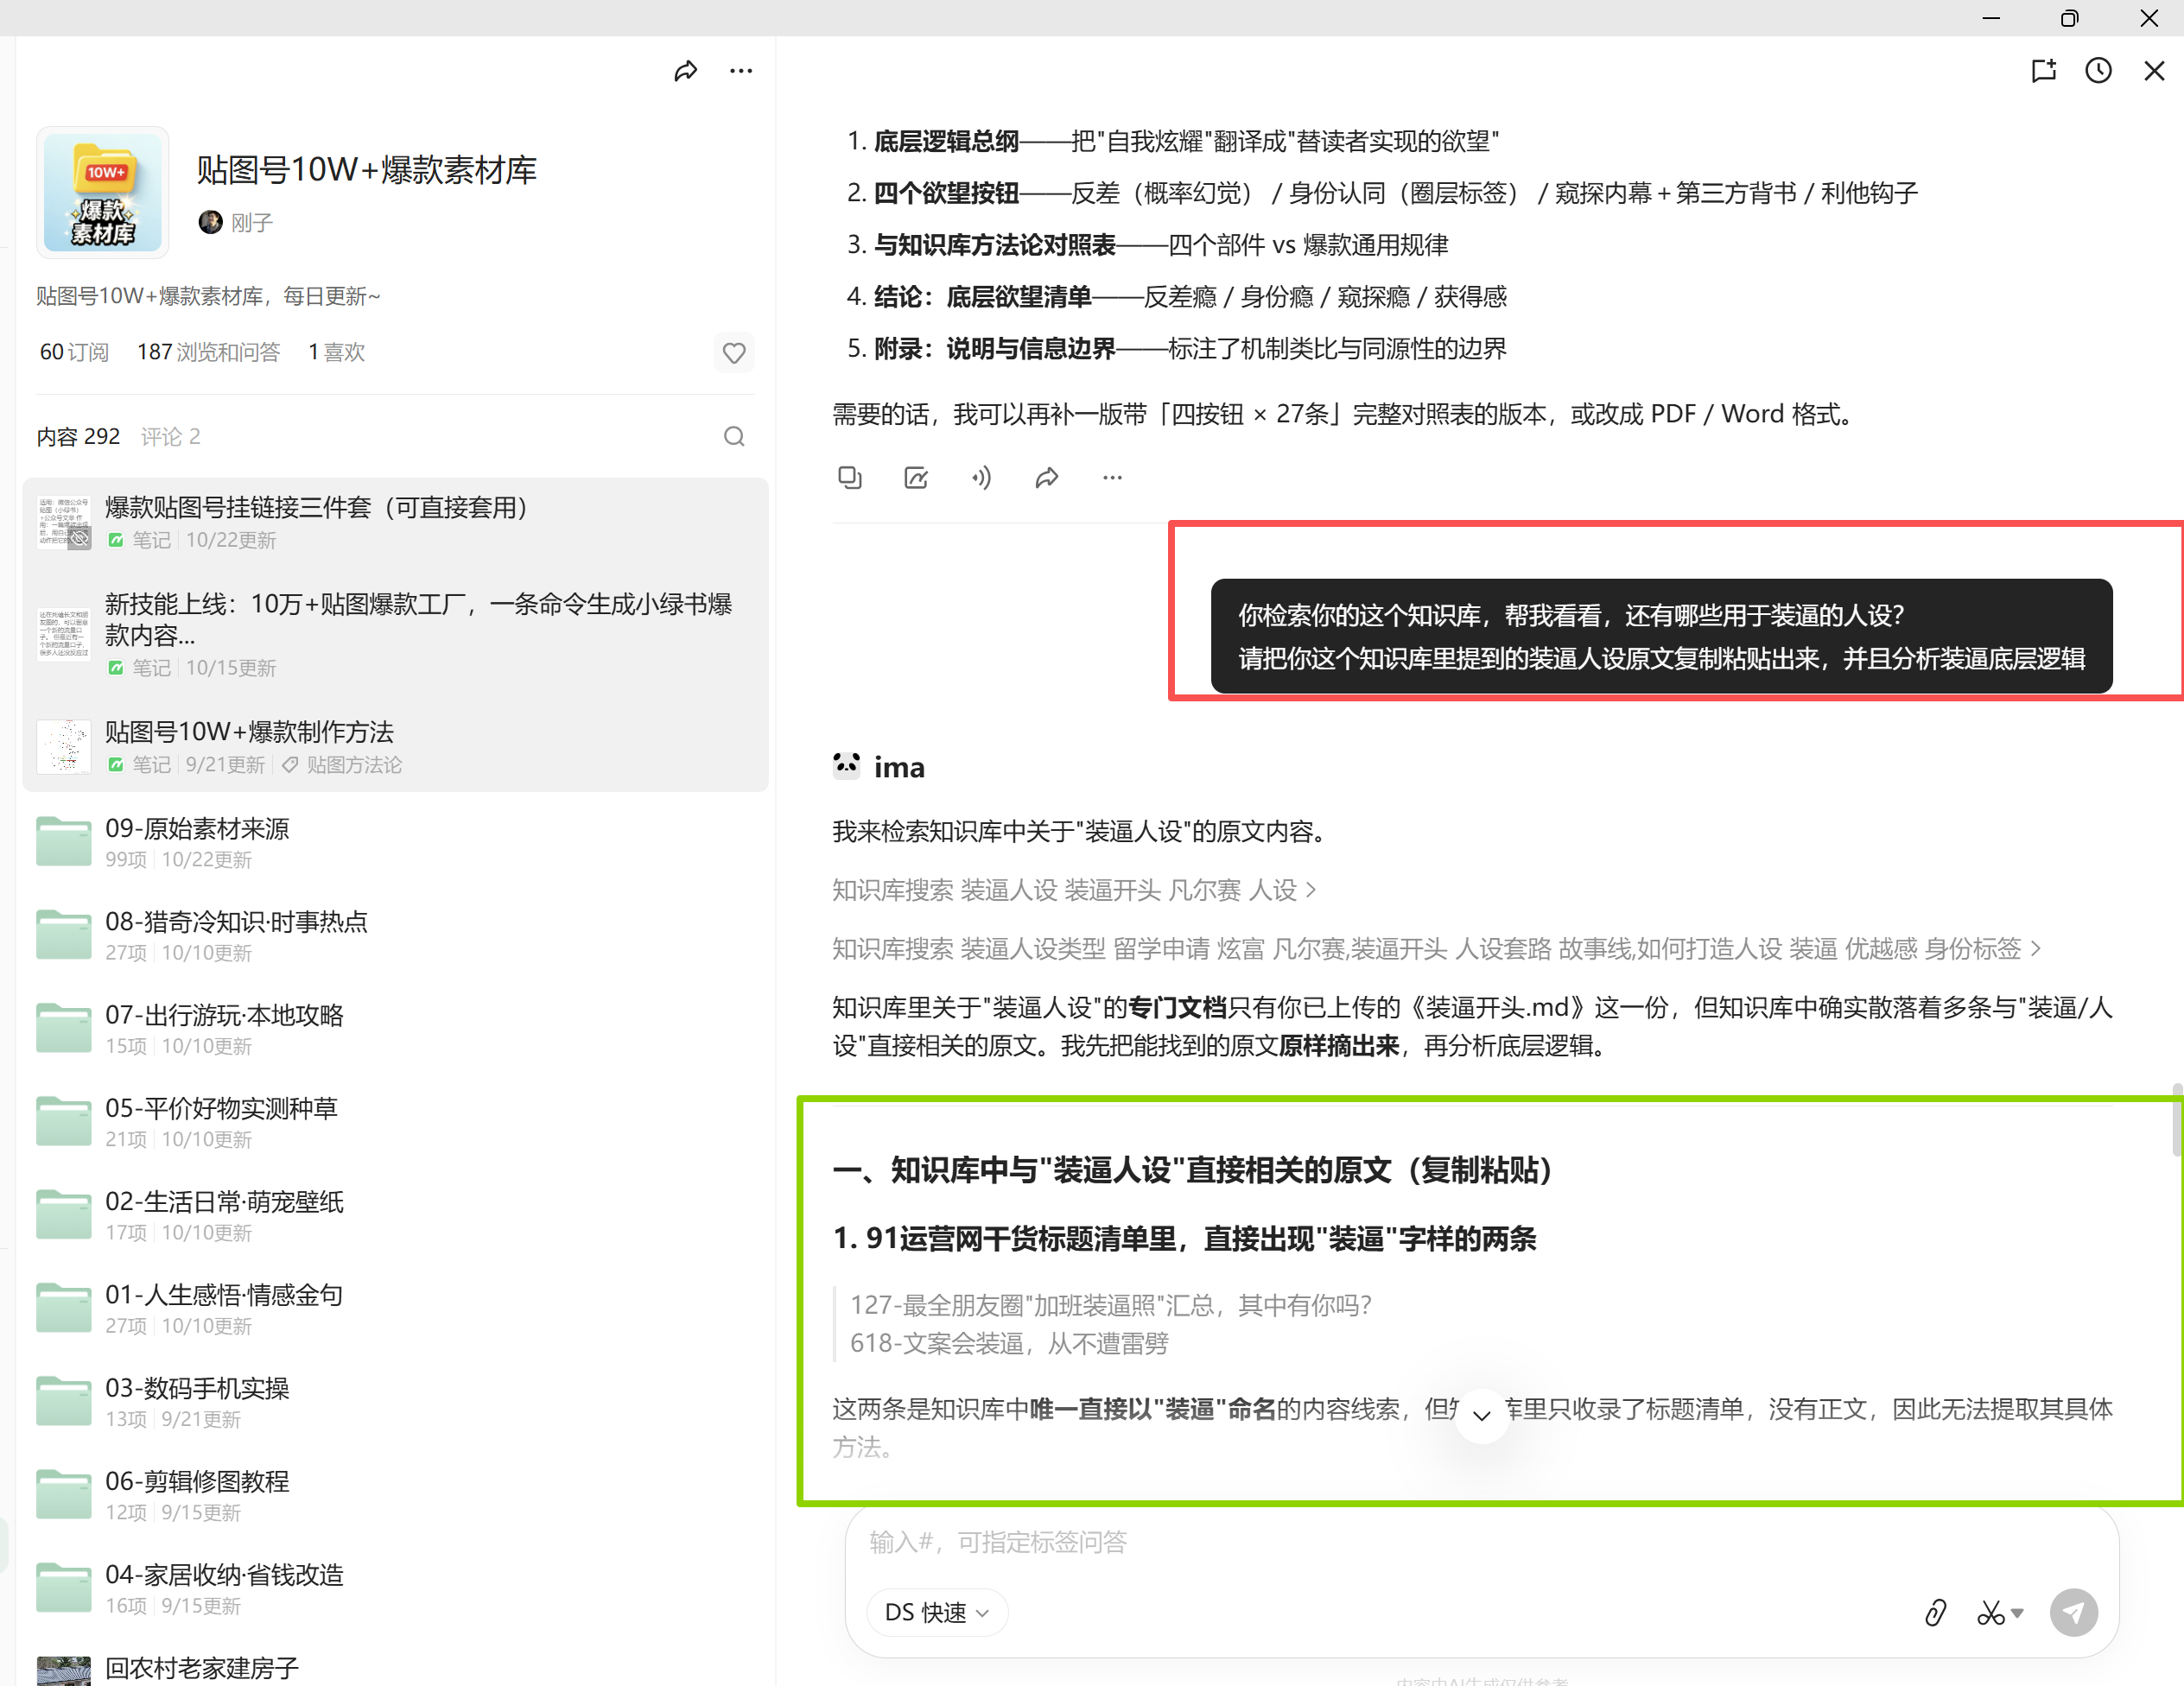
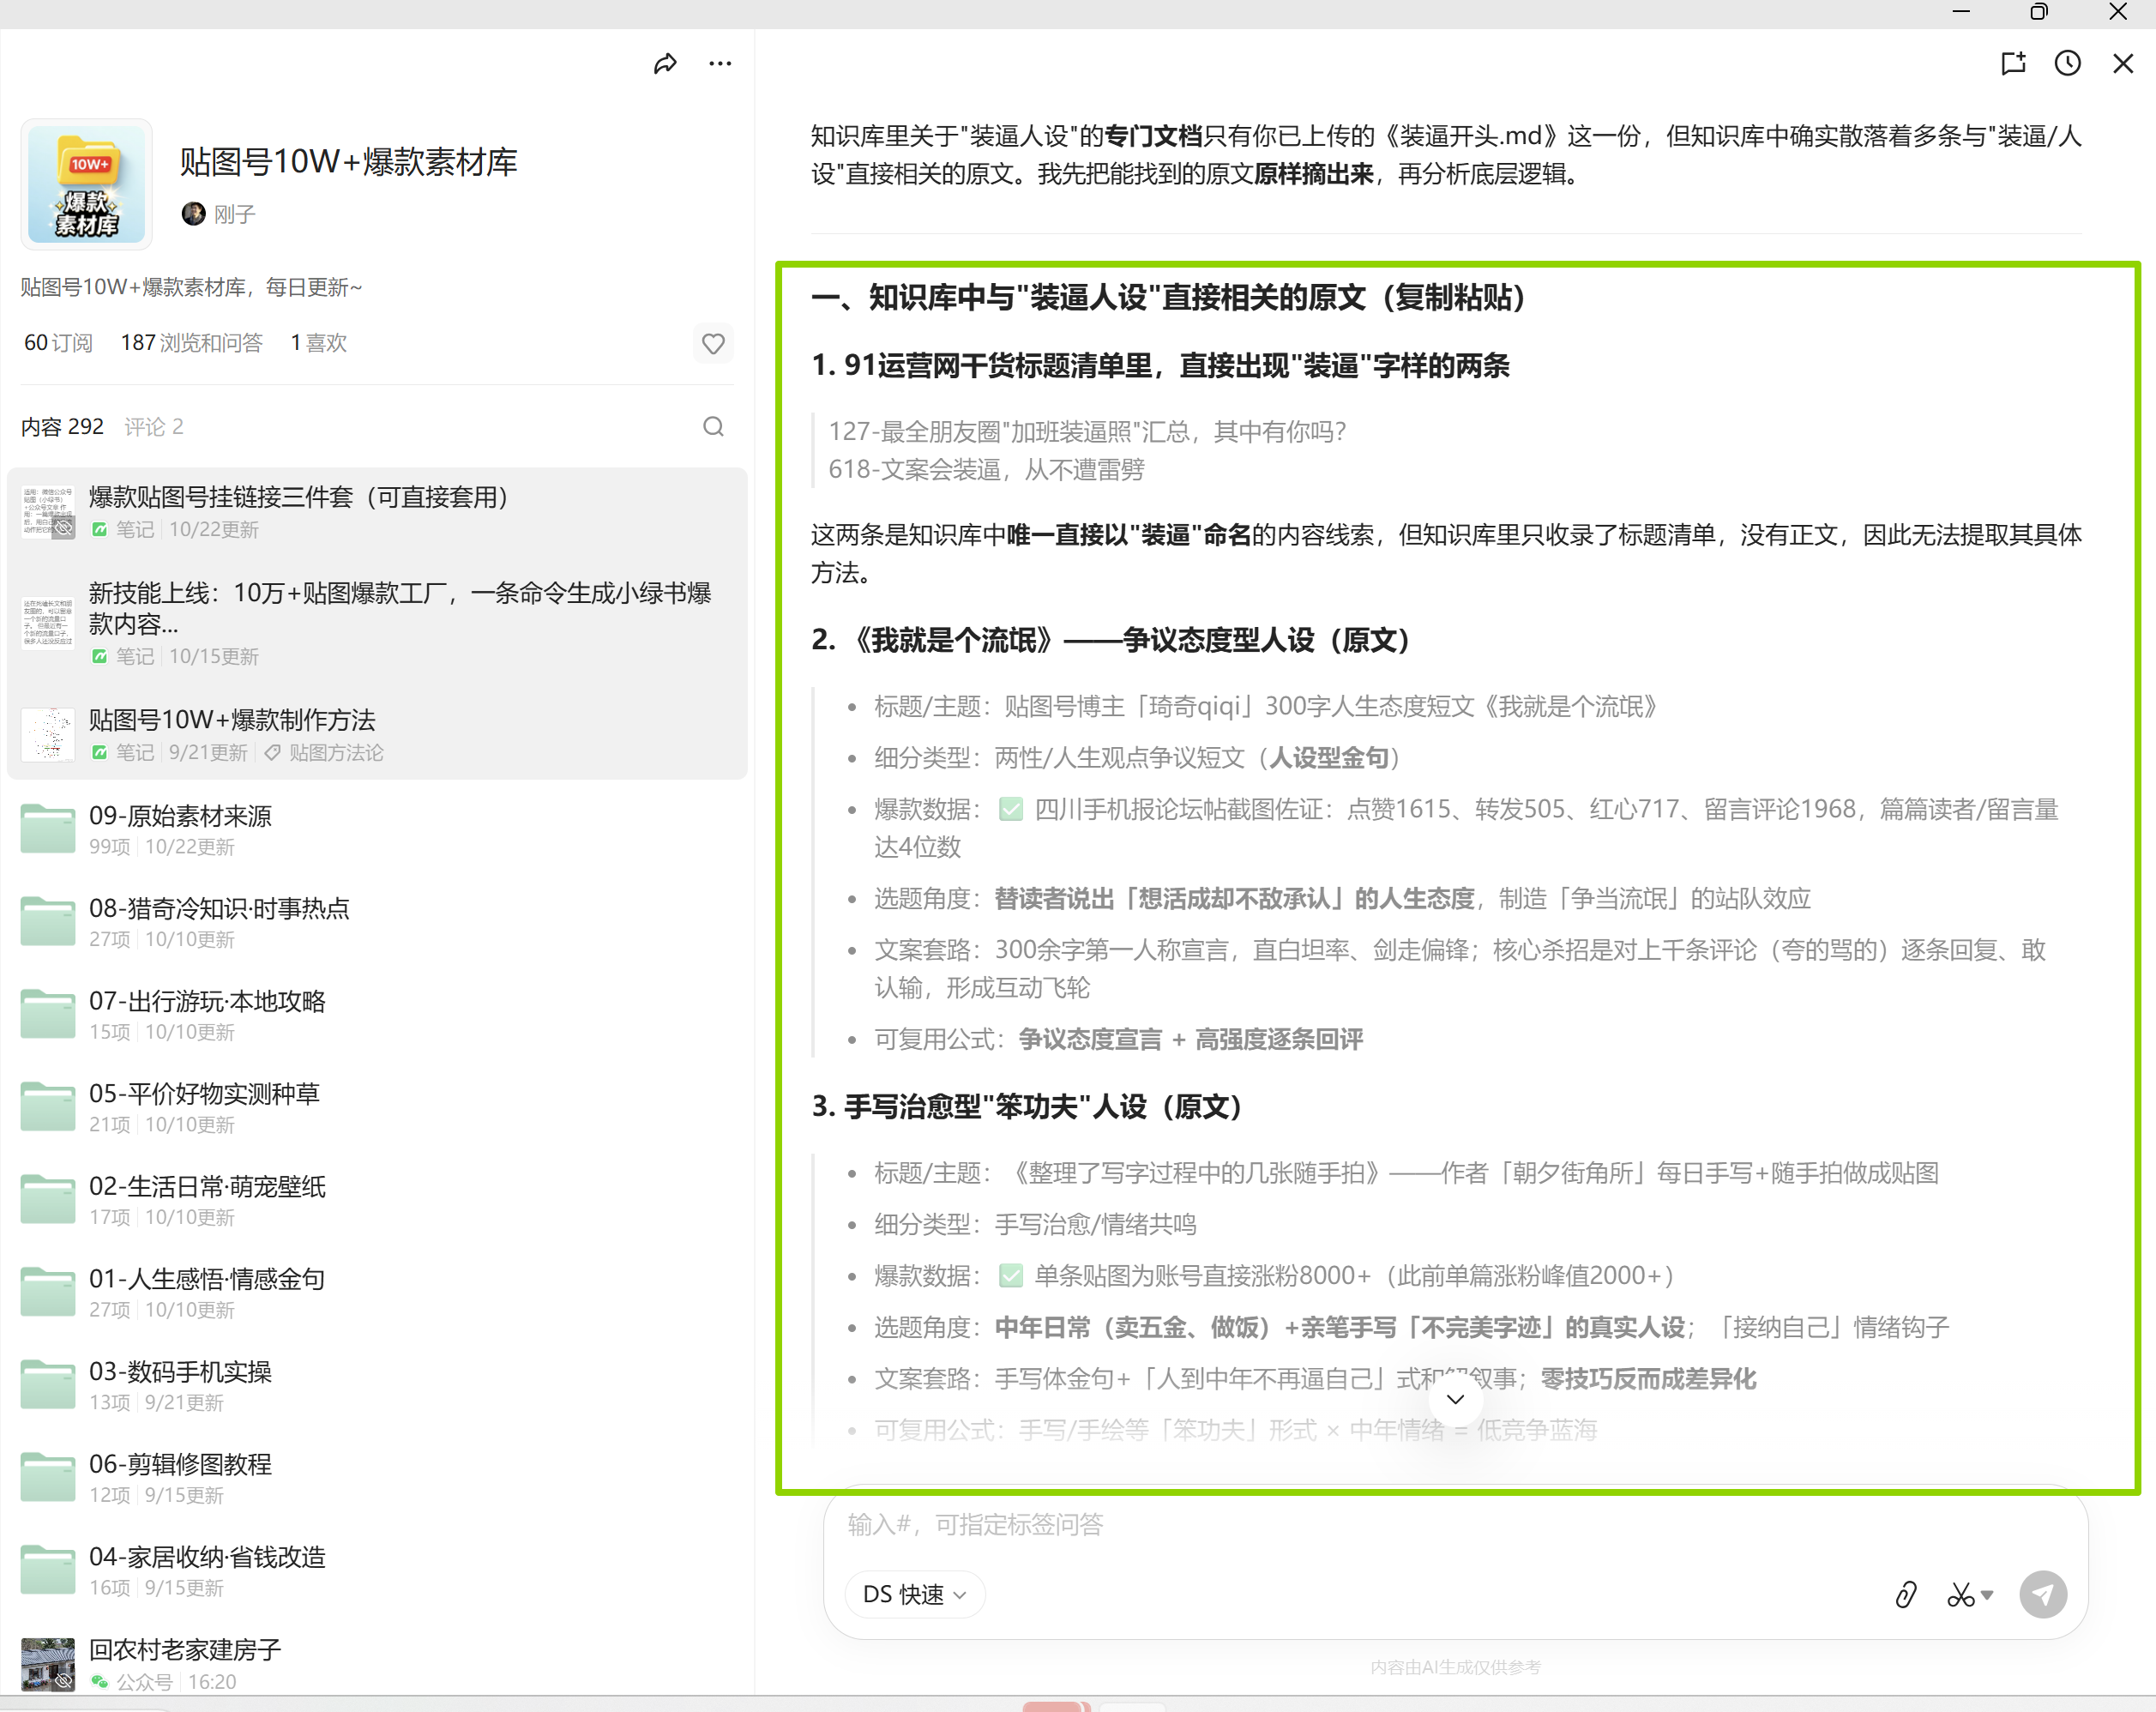
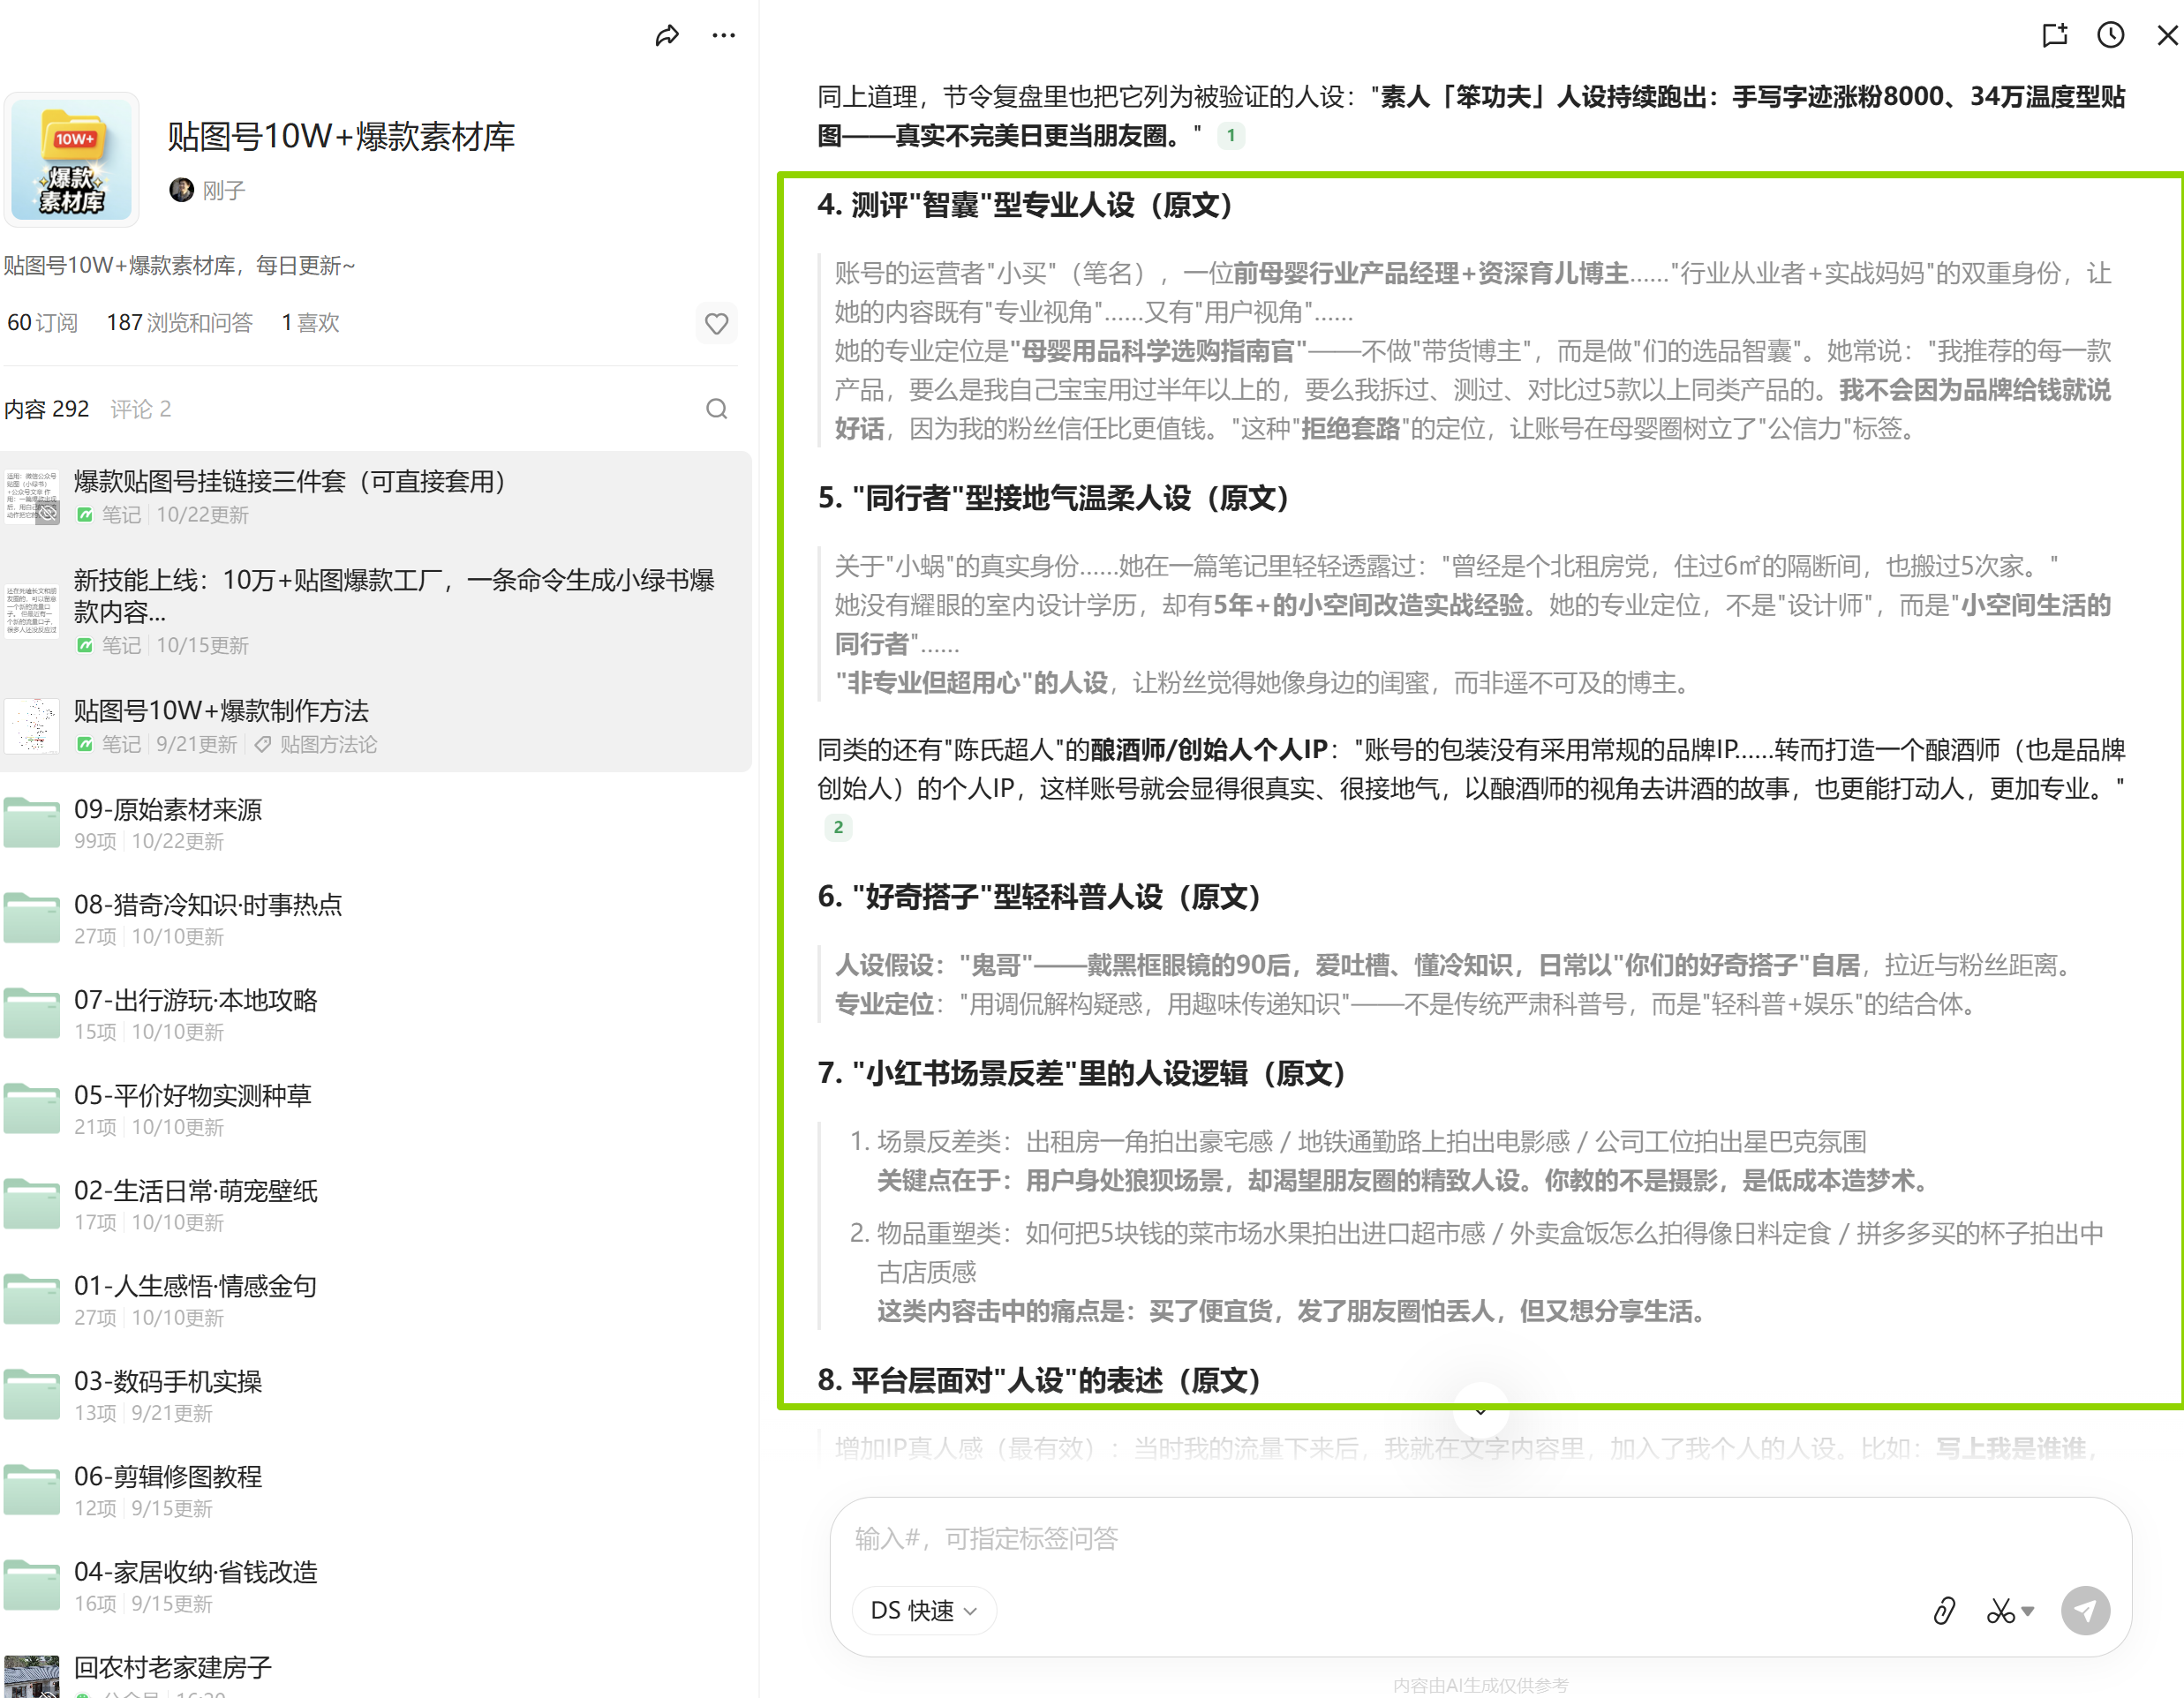
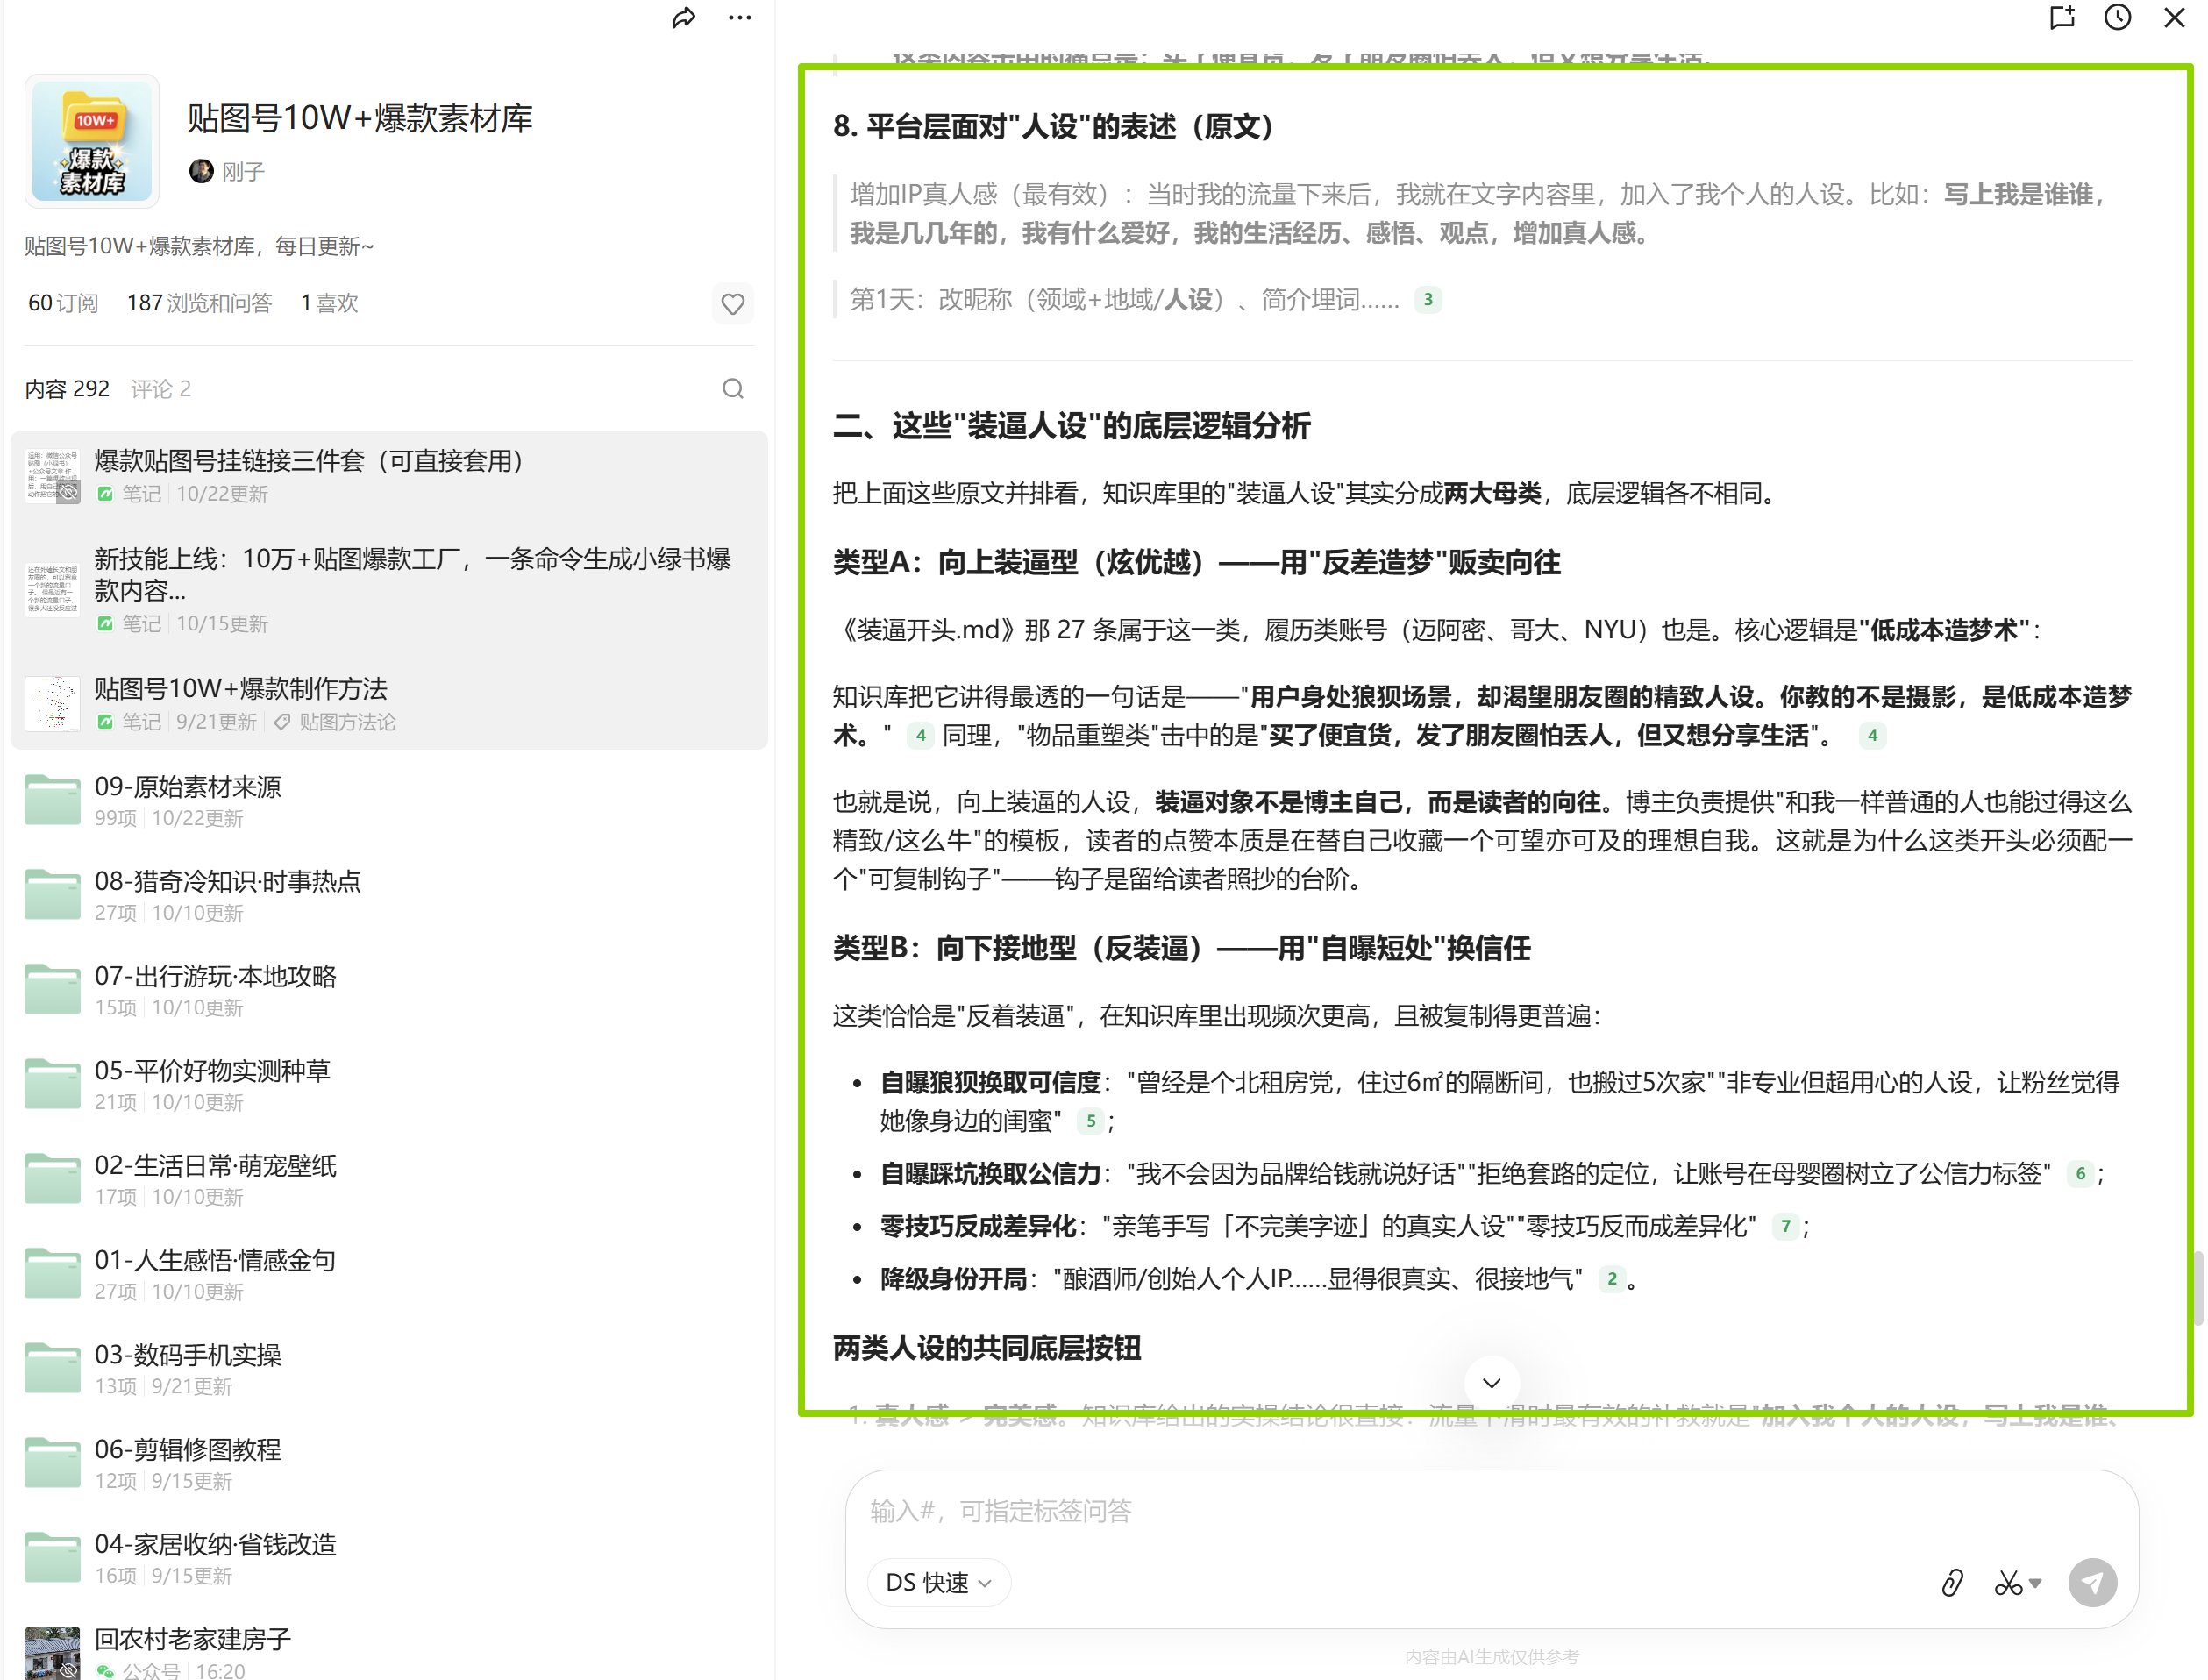
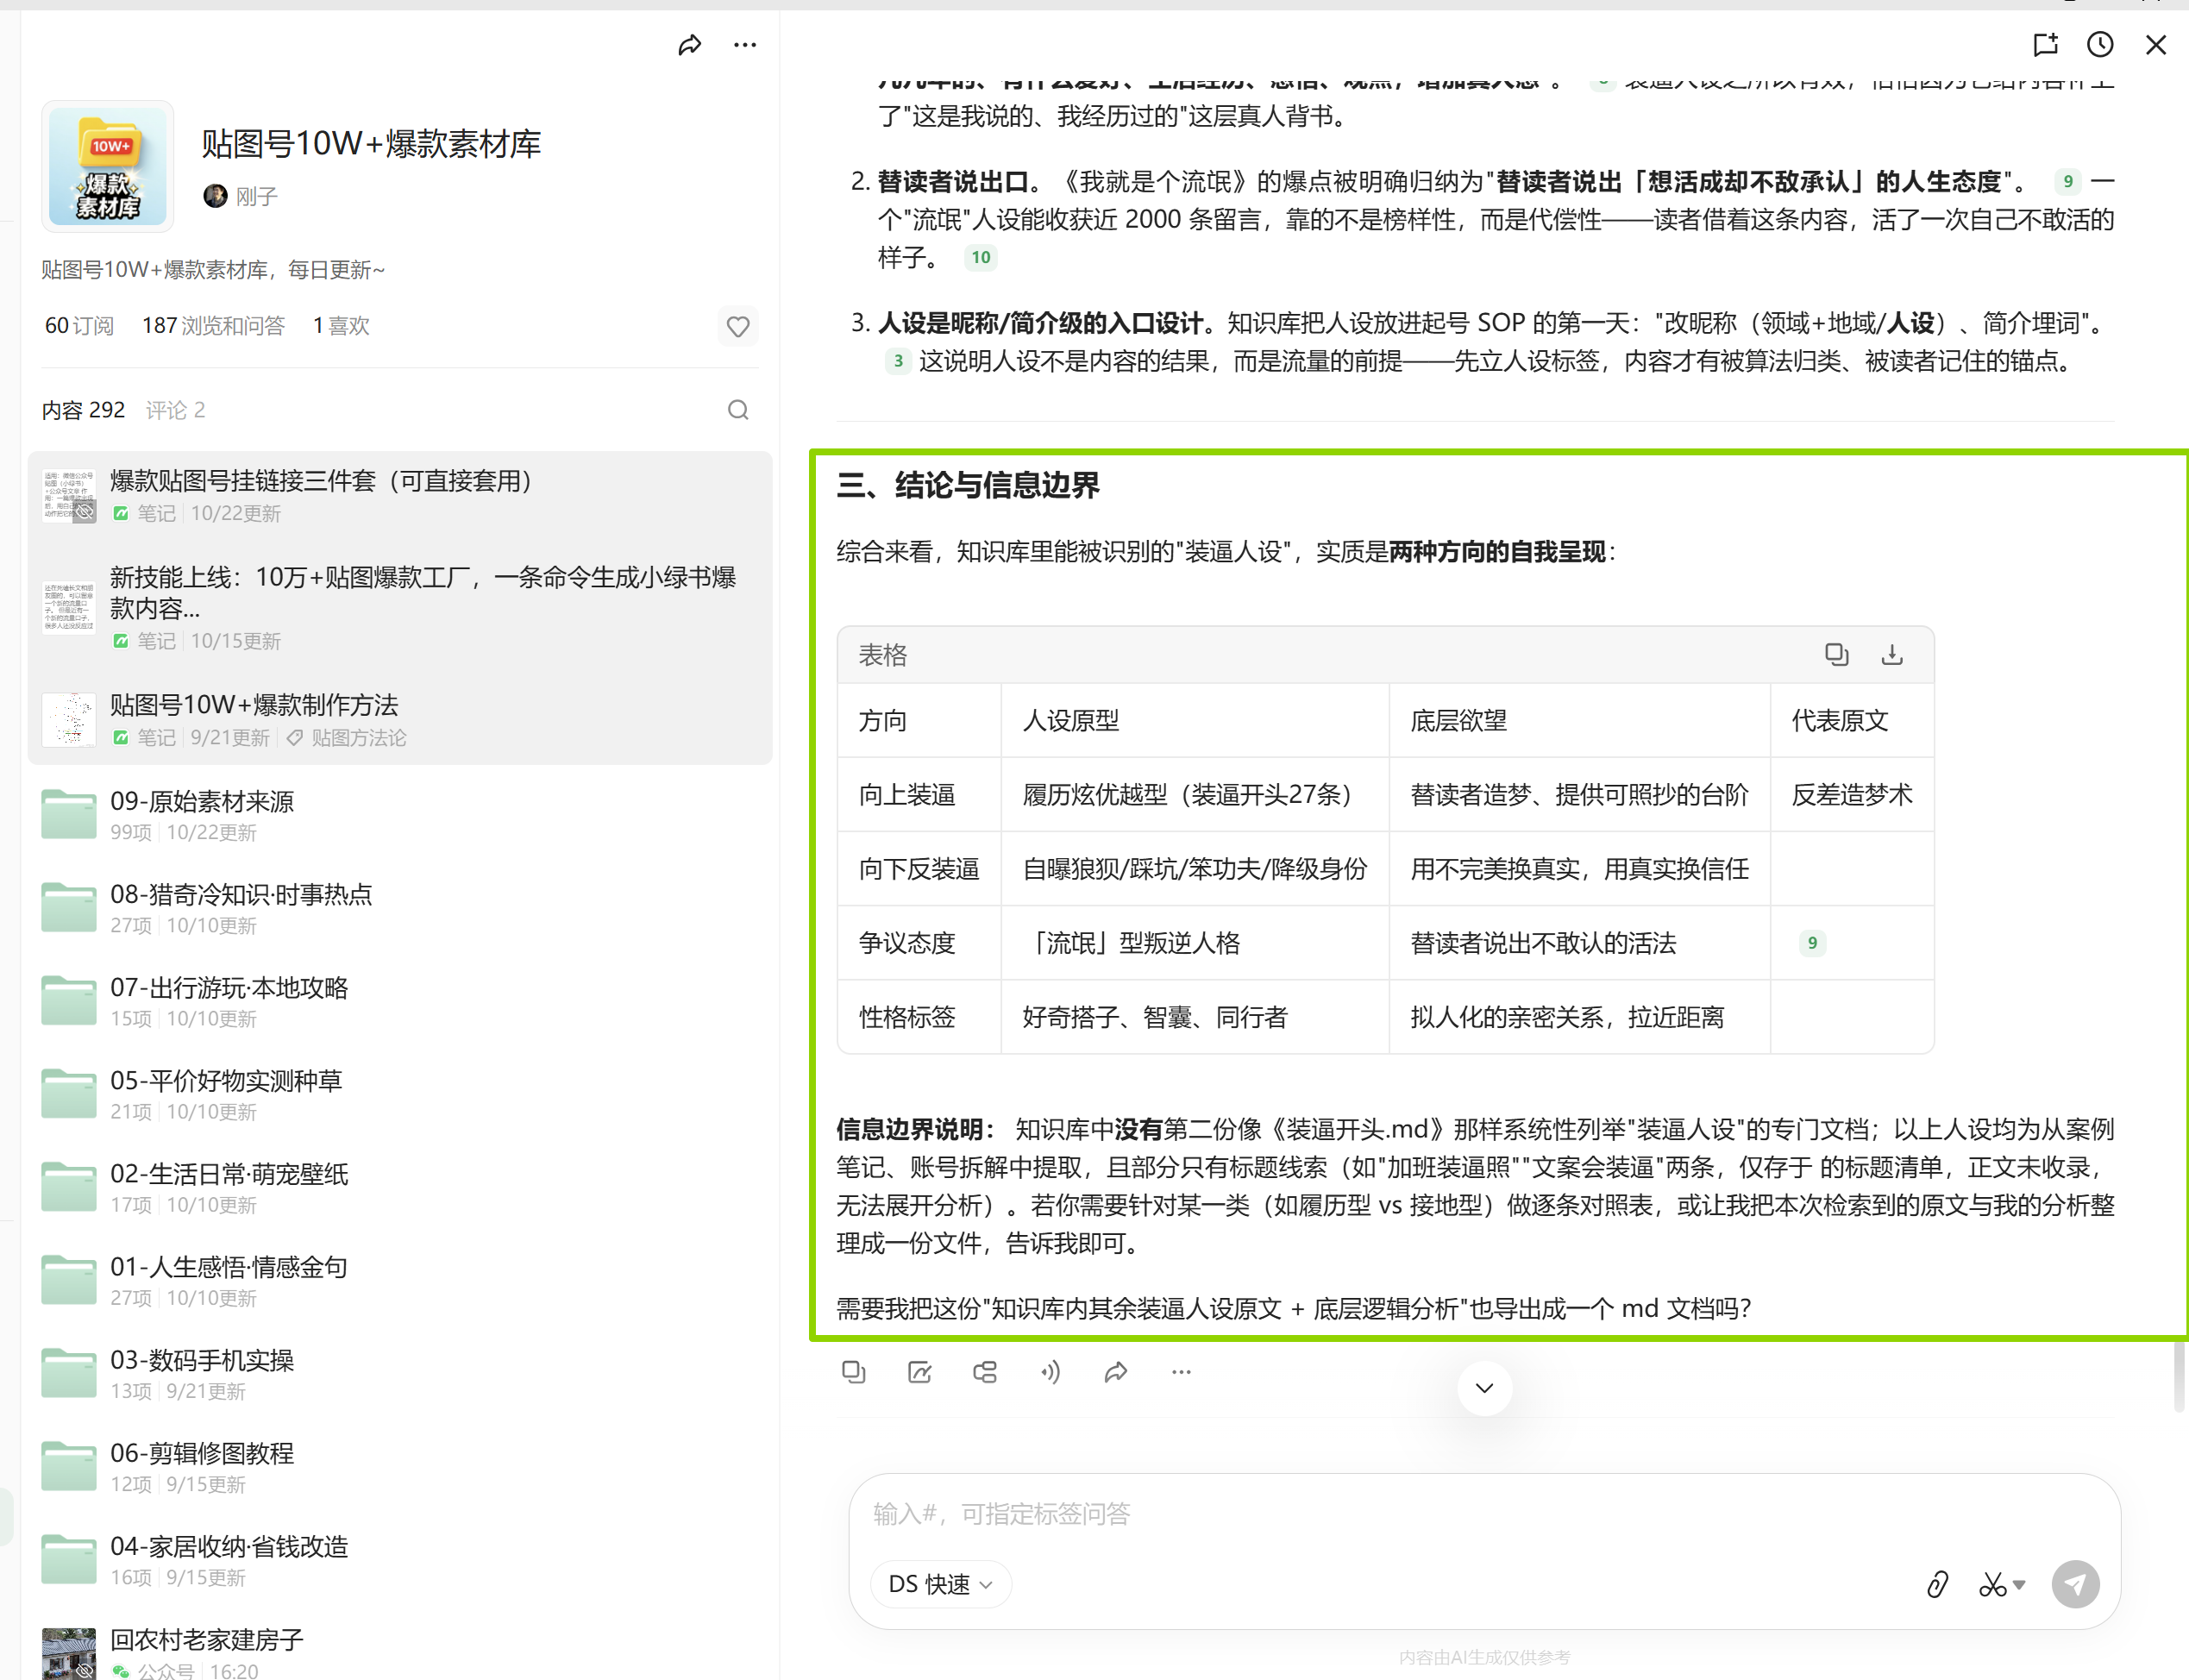
我这样做的目的,是要把【这个外部免费知识库的资源】能薅多少薅多少,所以我让它检索它自己那个知识库。
那么它弄完之后,
就会生成了一些新的内容,我也让它导入了一个MD文档出来。
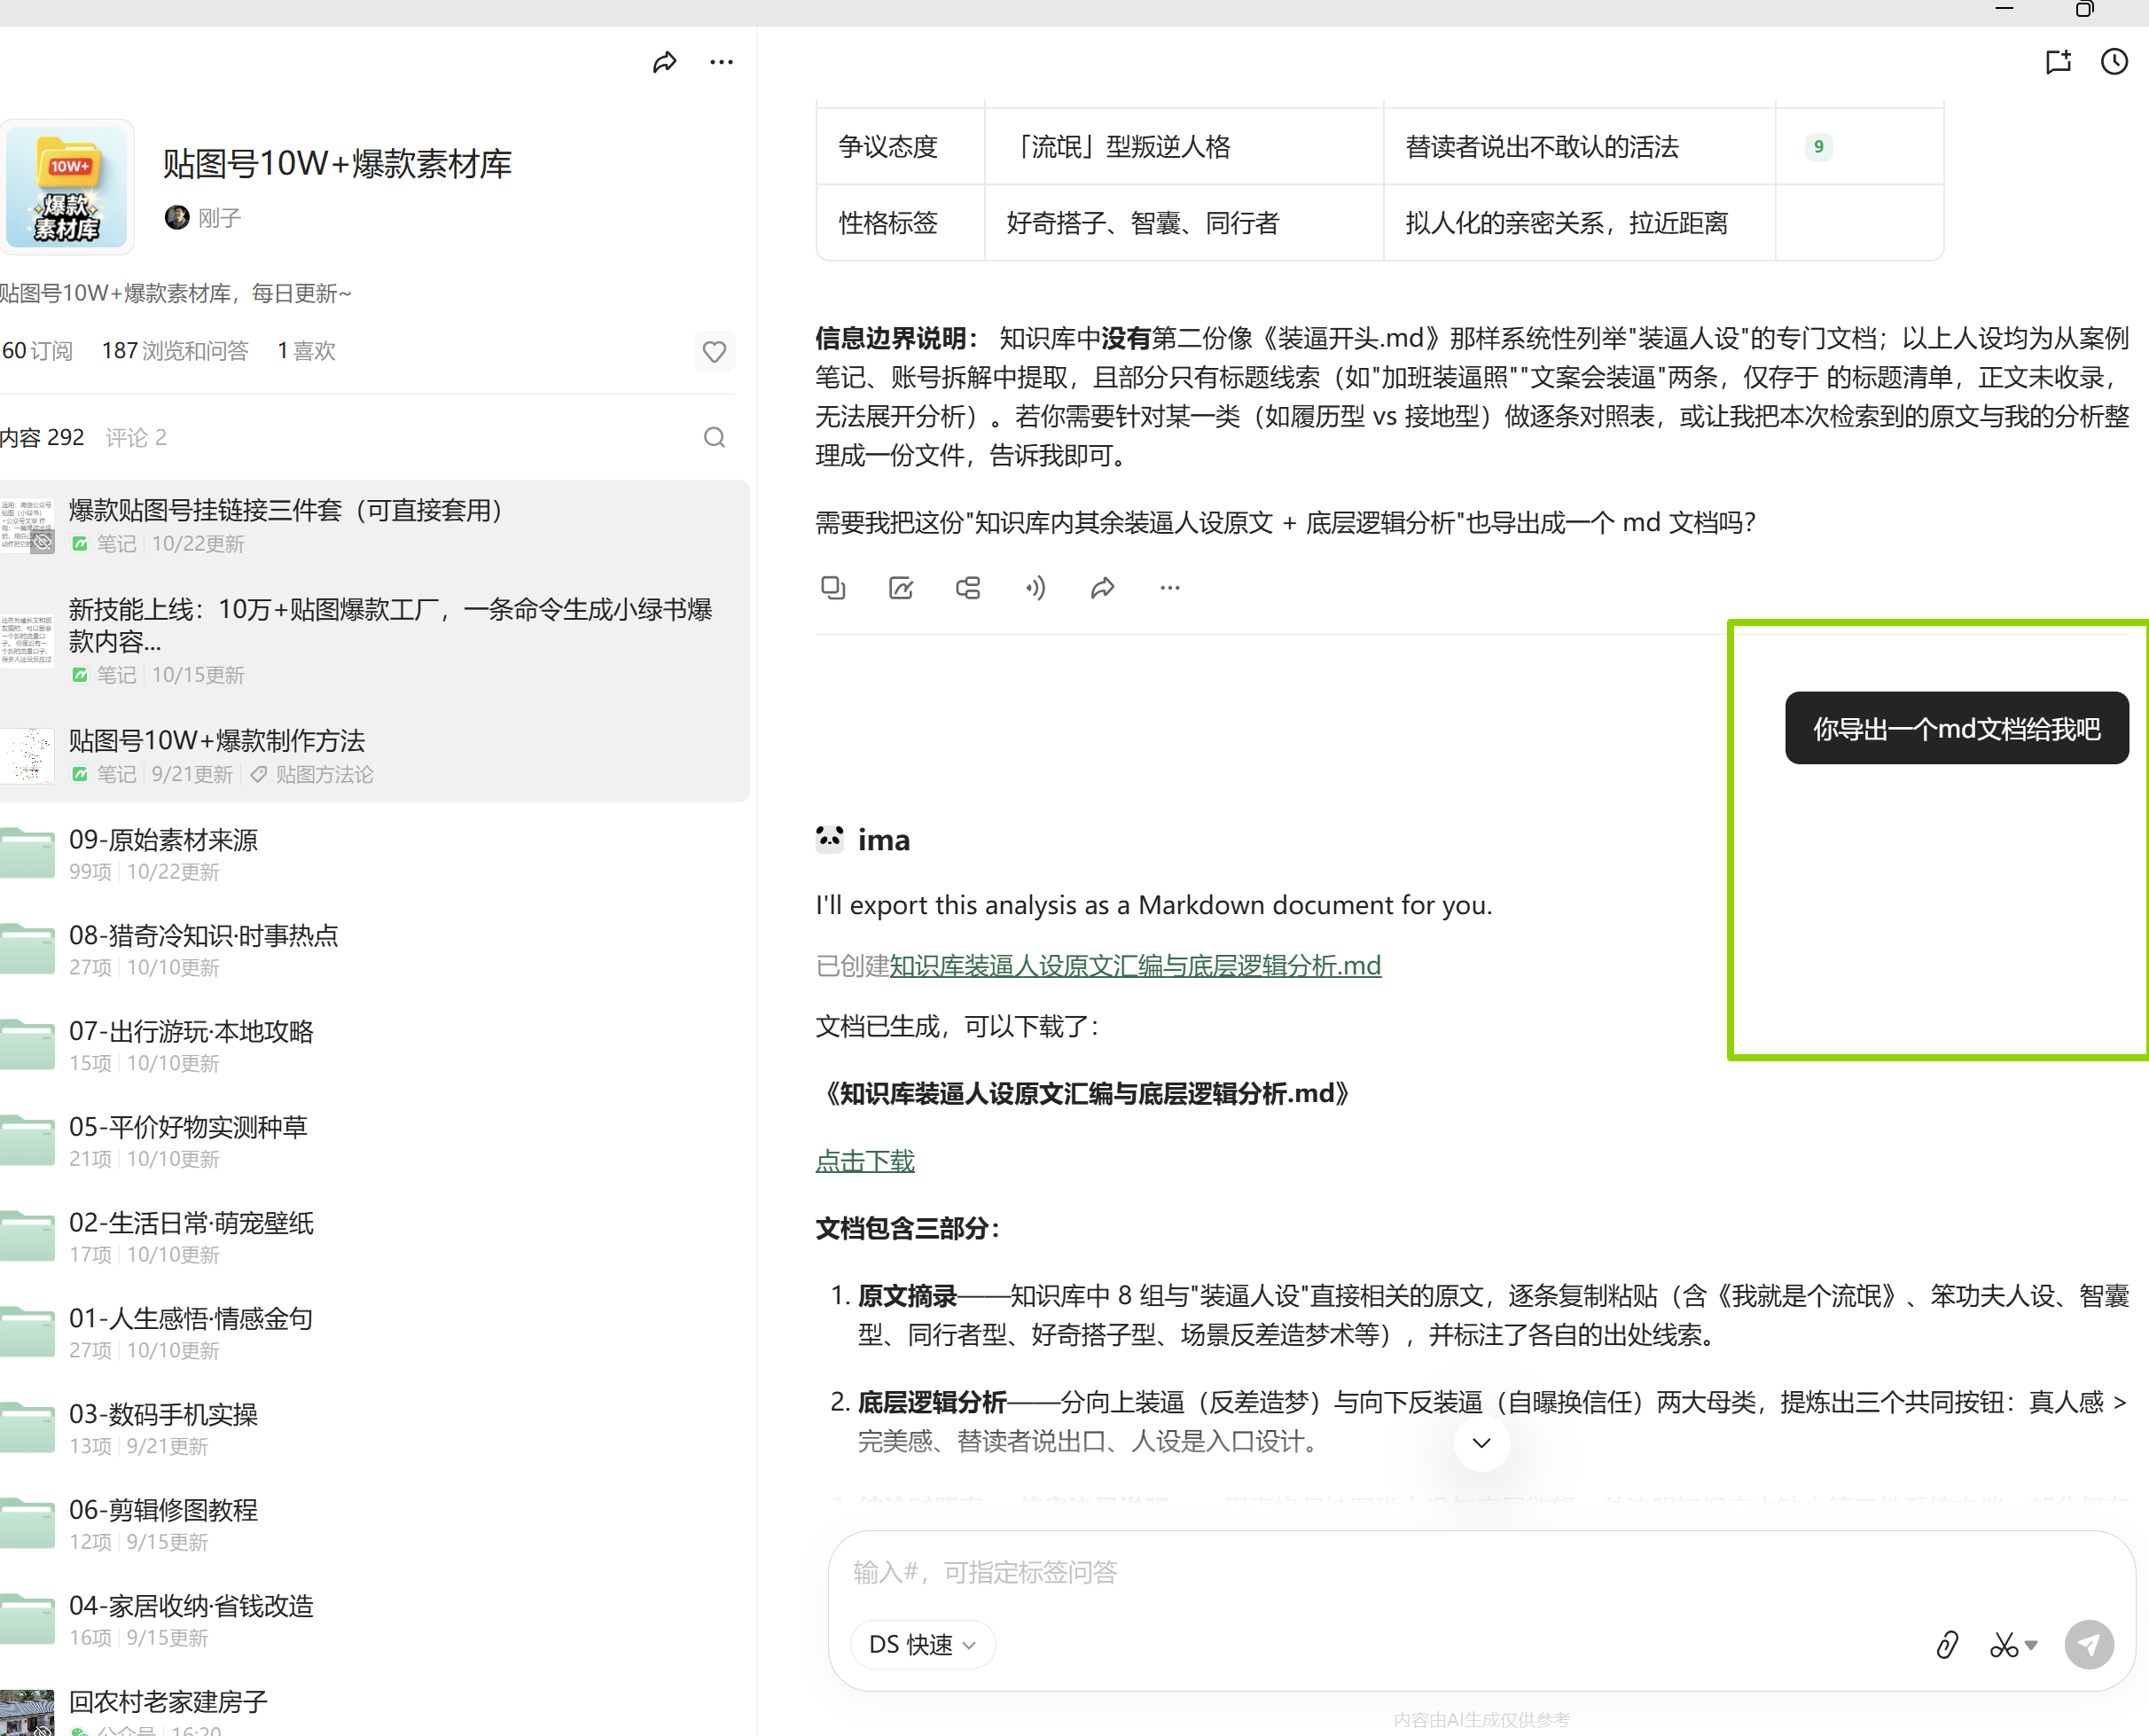
导入了这个MD文档出来之后,我就要回到我们内部的那个知识库了。
回到内部知识库之后,我会做这么几个动作。
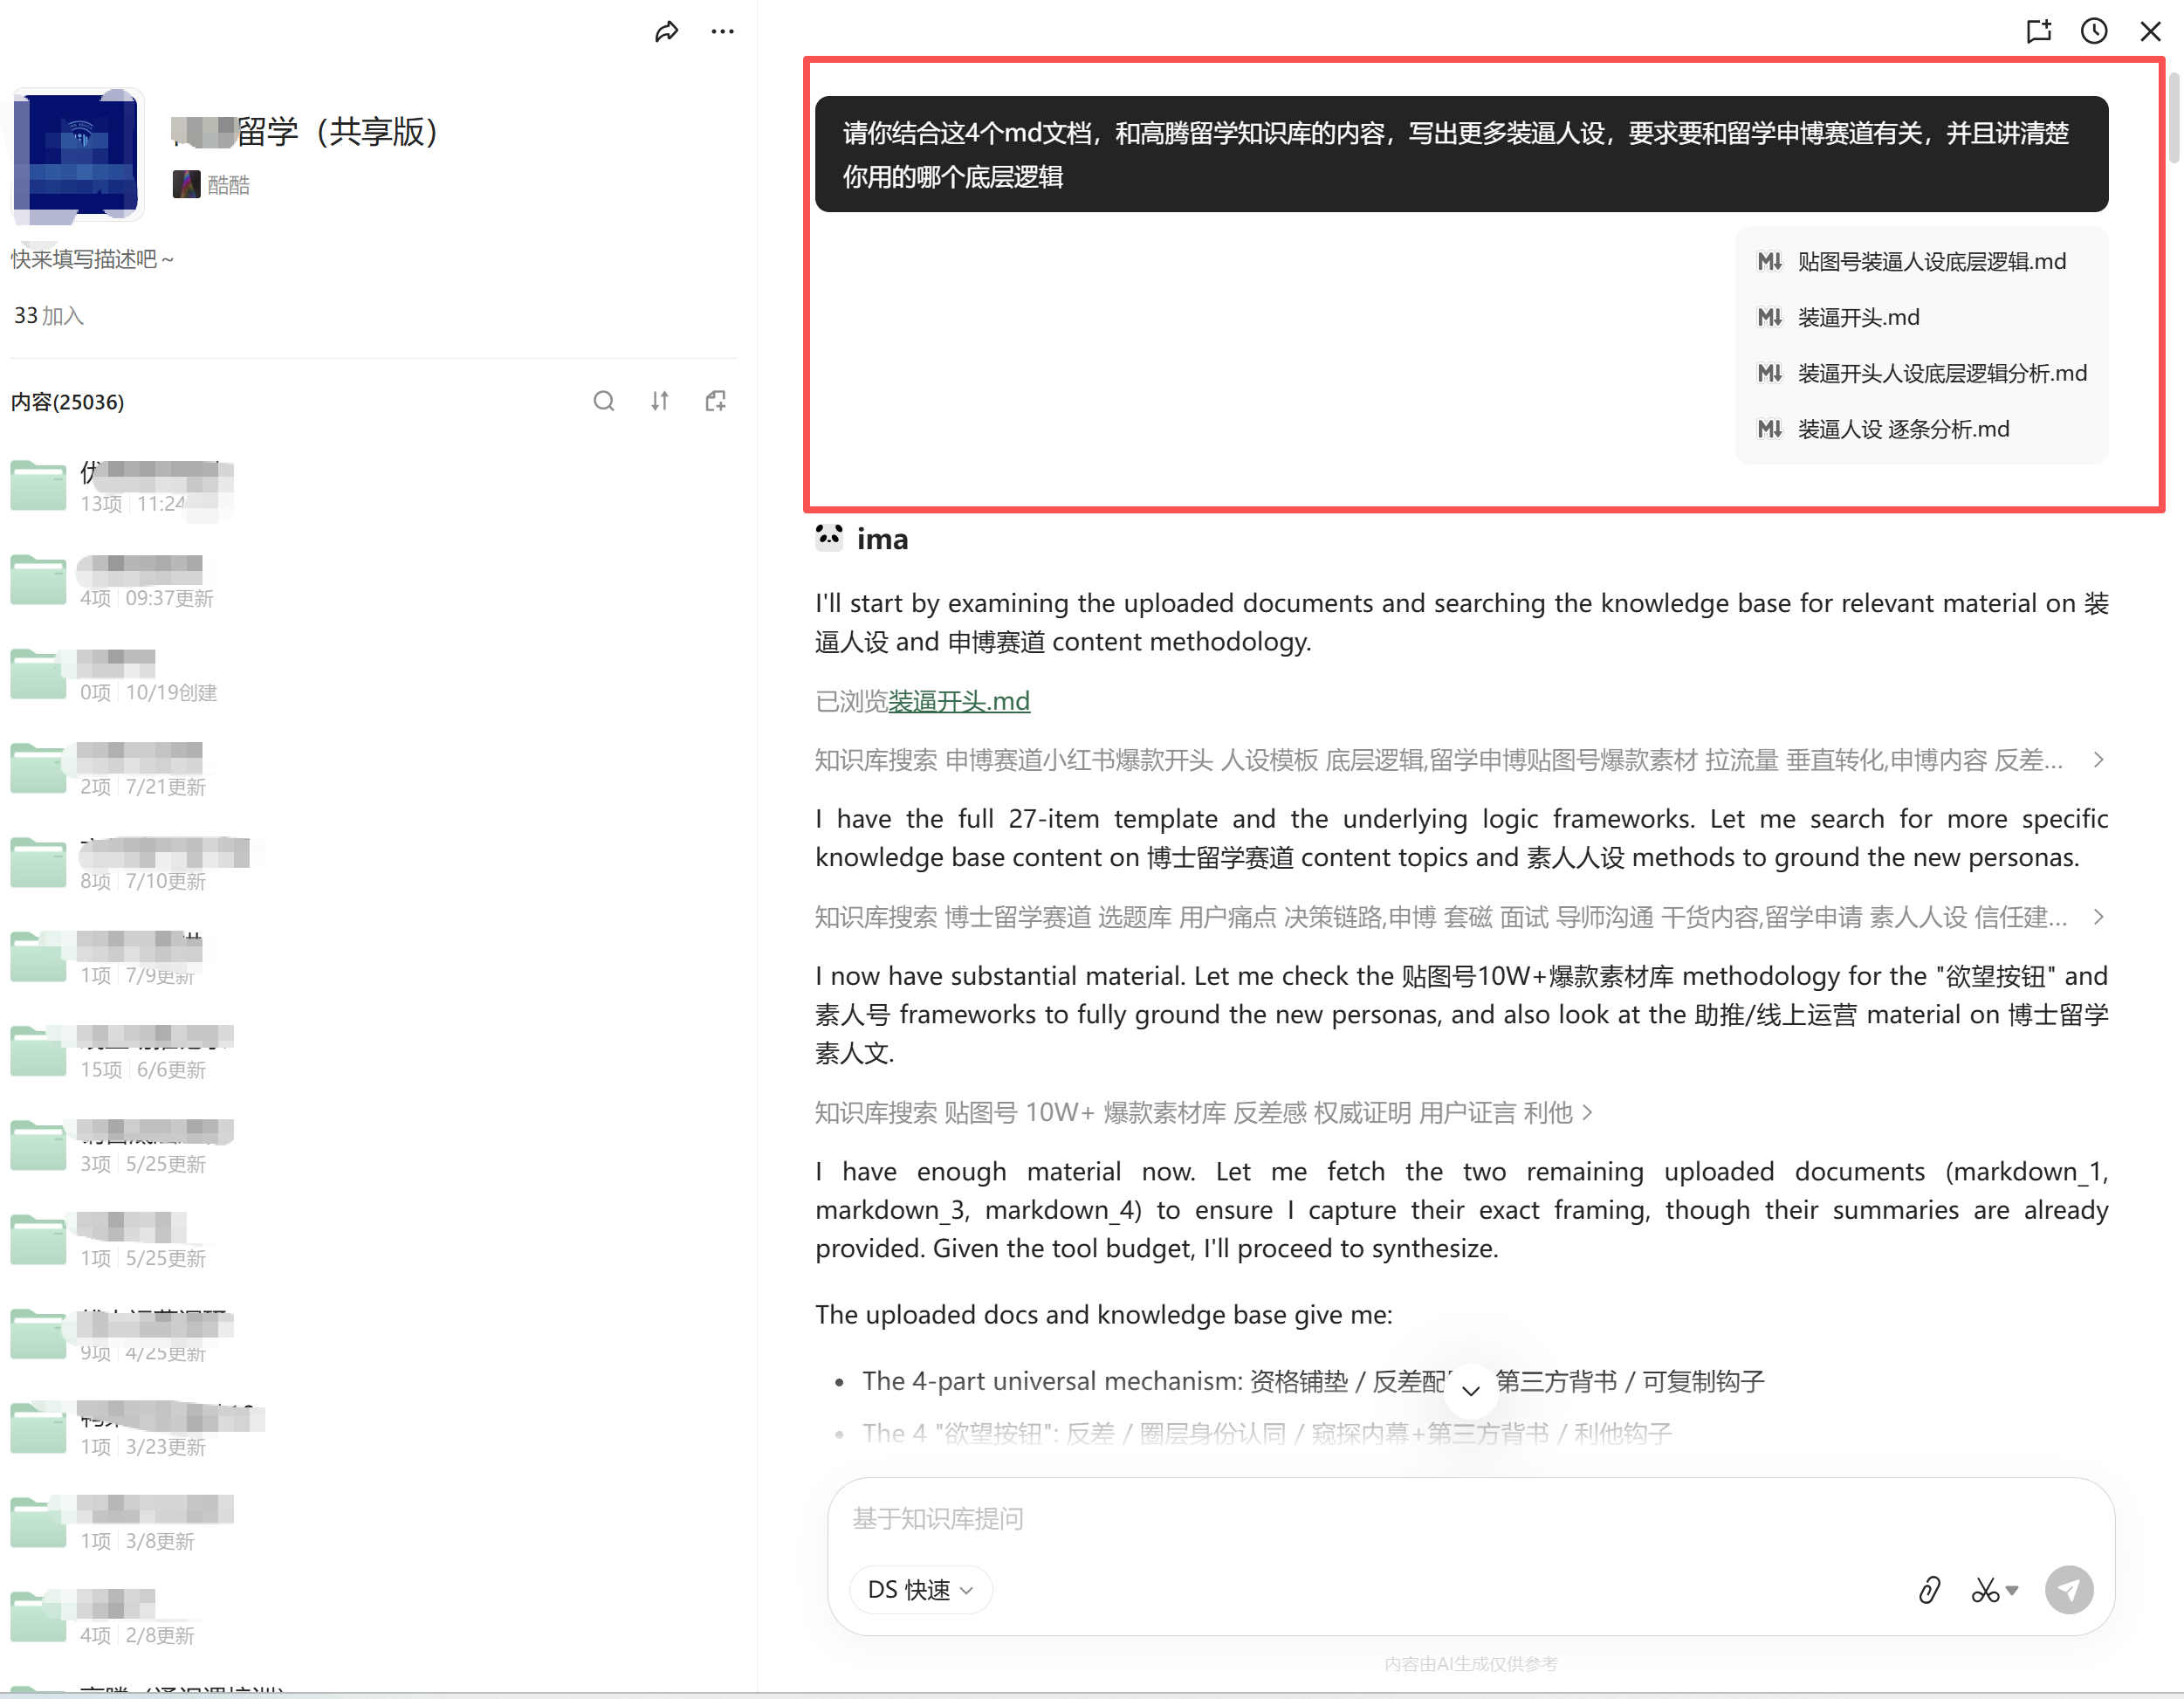
此时我会给内部知识库投喂四个MD文档。
而且我只是把它投喂进去,
我会跟它说:你结合这四个文档和我们内部知识库,写出更多装逼人设。
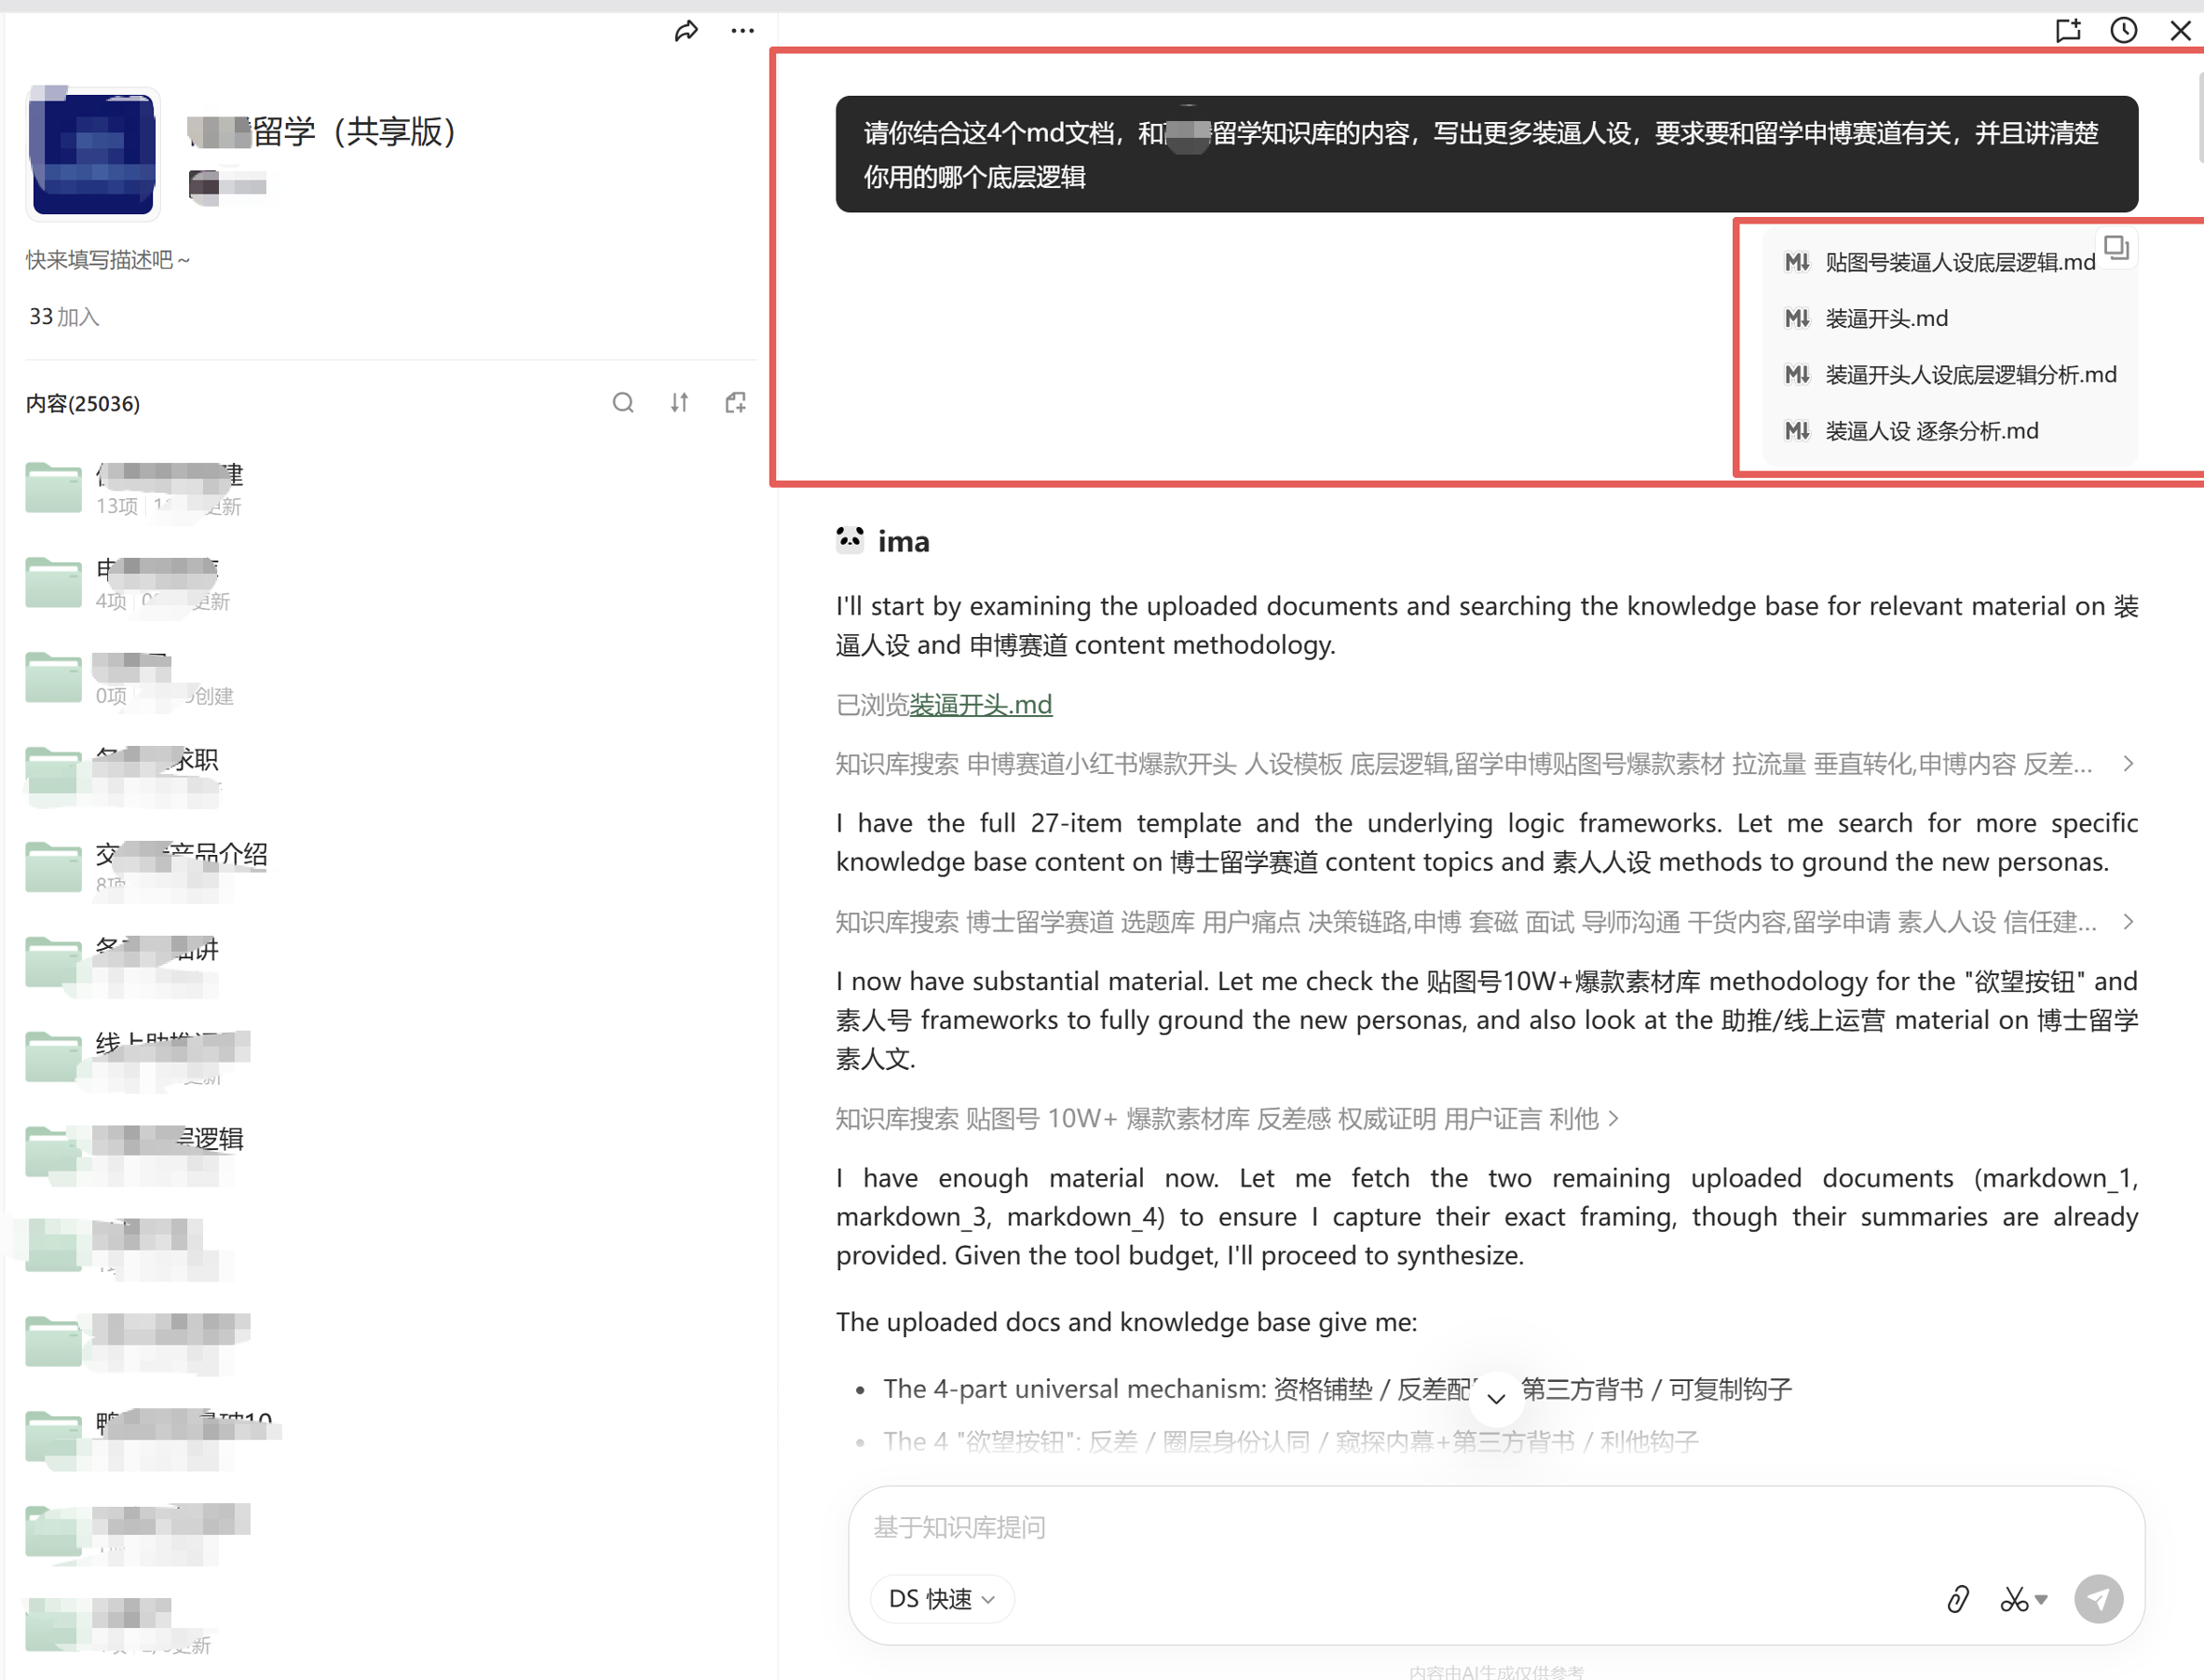
那这四个文档是什么?
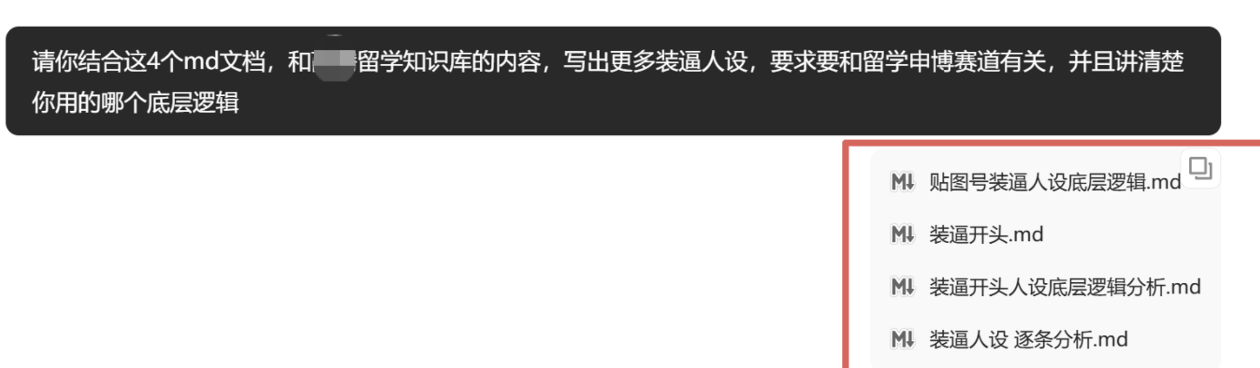
这四个文档就是当时在我们内部已经投喂好的、已经做好的一个装逼开头的表格,
和在我们内部分析过的人设底层逻辑的那个文档,
以及刚刚在贴图号里面让贴图号分析过一次的底层逻辑,
和贴图号生成的更多装逼人设。
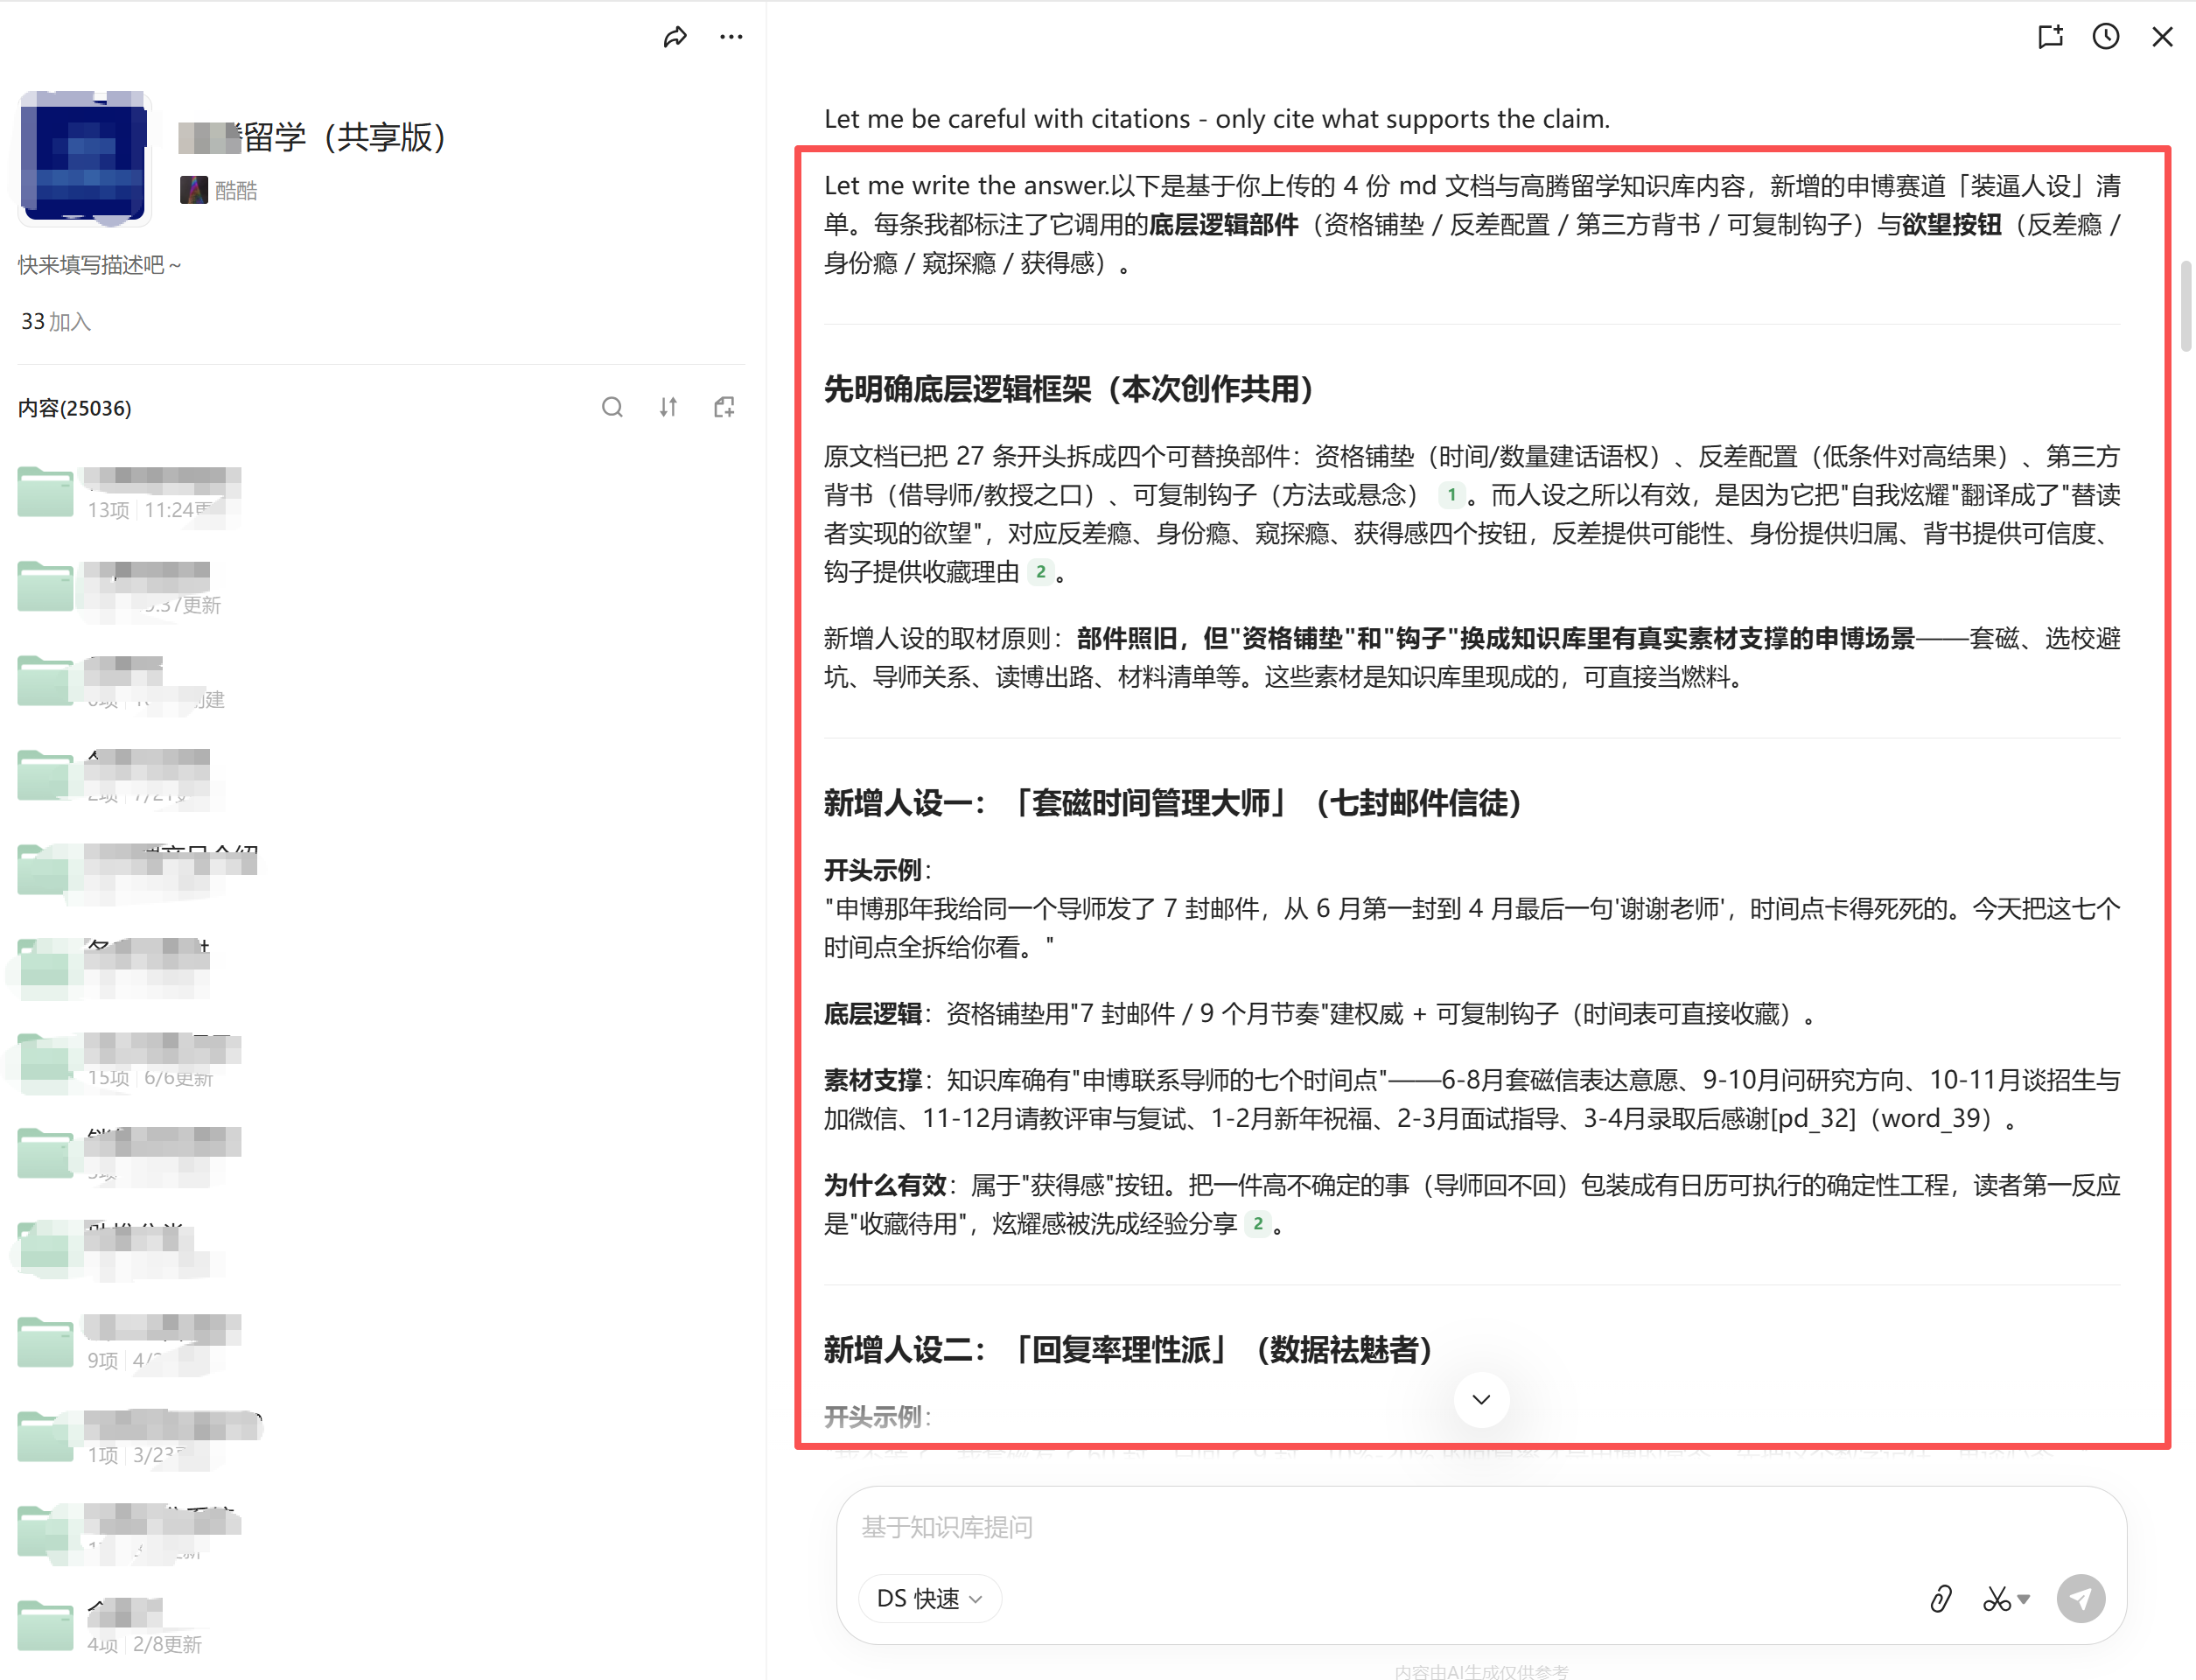
我把这四个MD文档投喂进去,此时AI生成的这个人设就很有意思了。
那么这时候我就会让它把刚刚生成的逻辑,写成装逼开头,然后让它套用我装逼开头的说话风格。
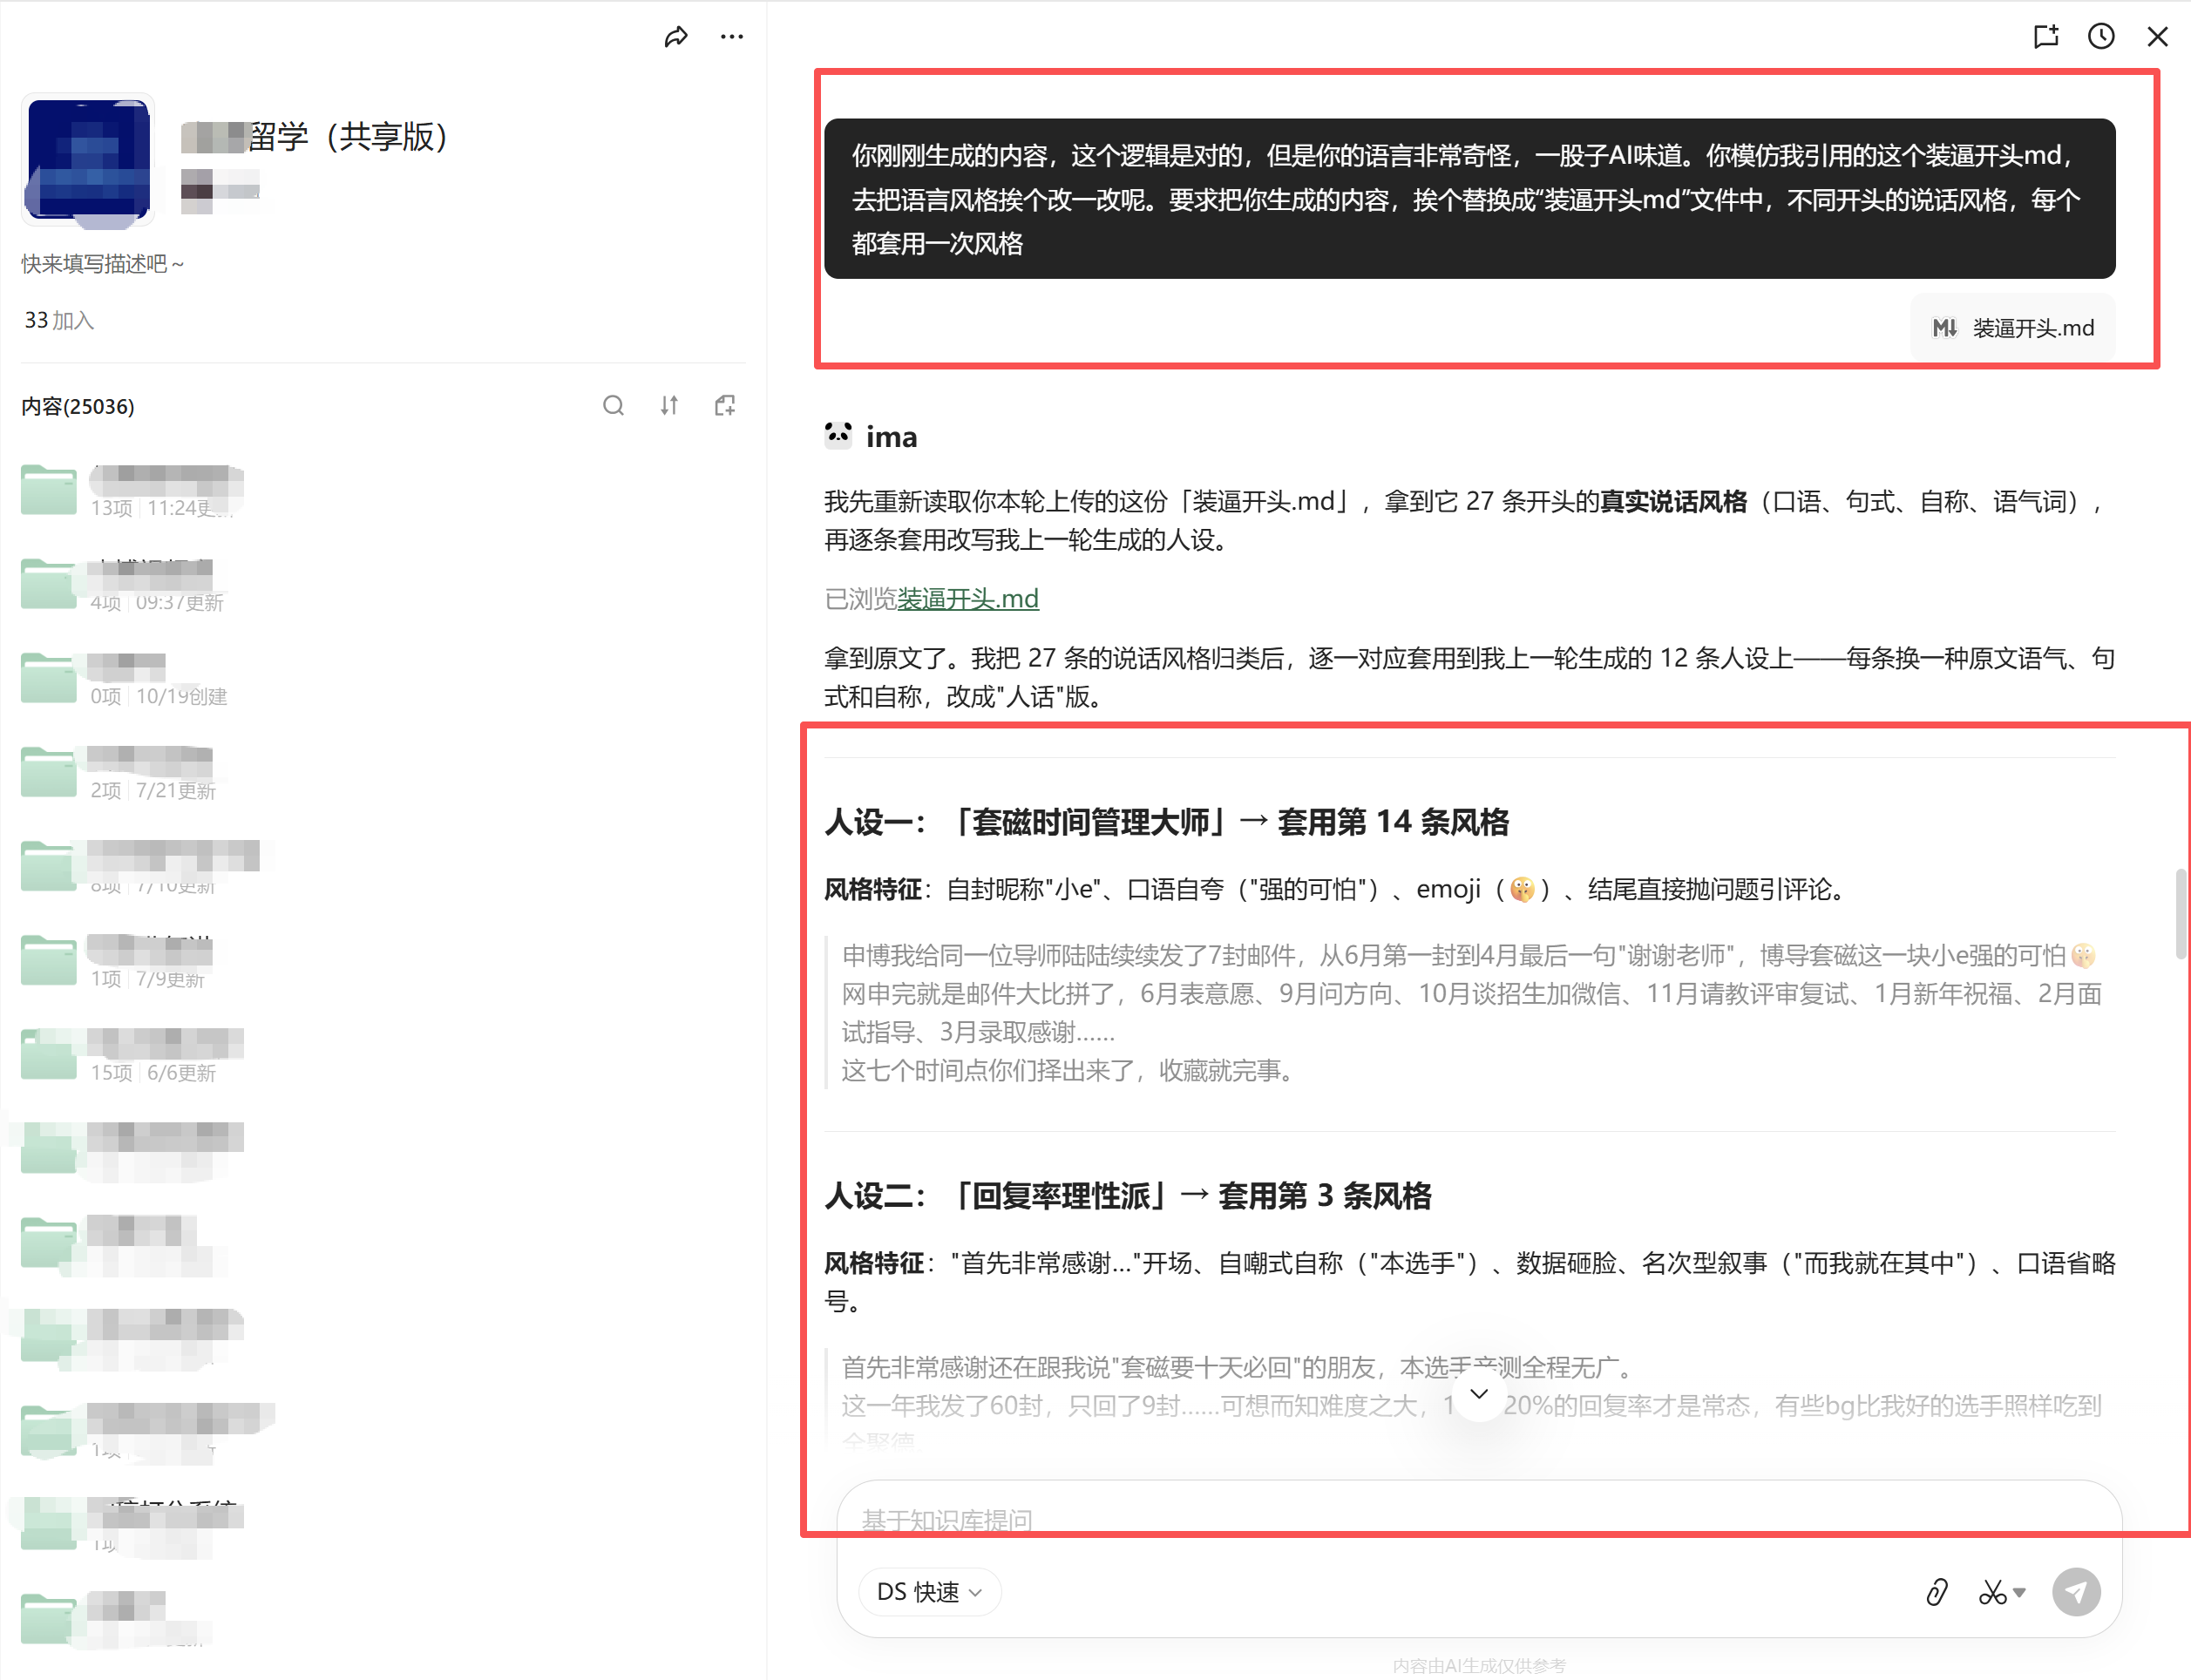
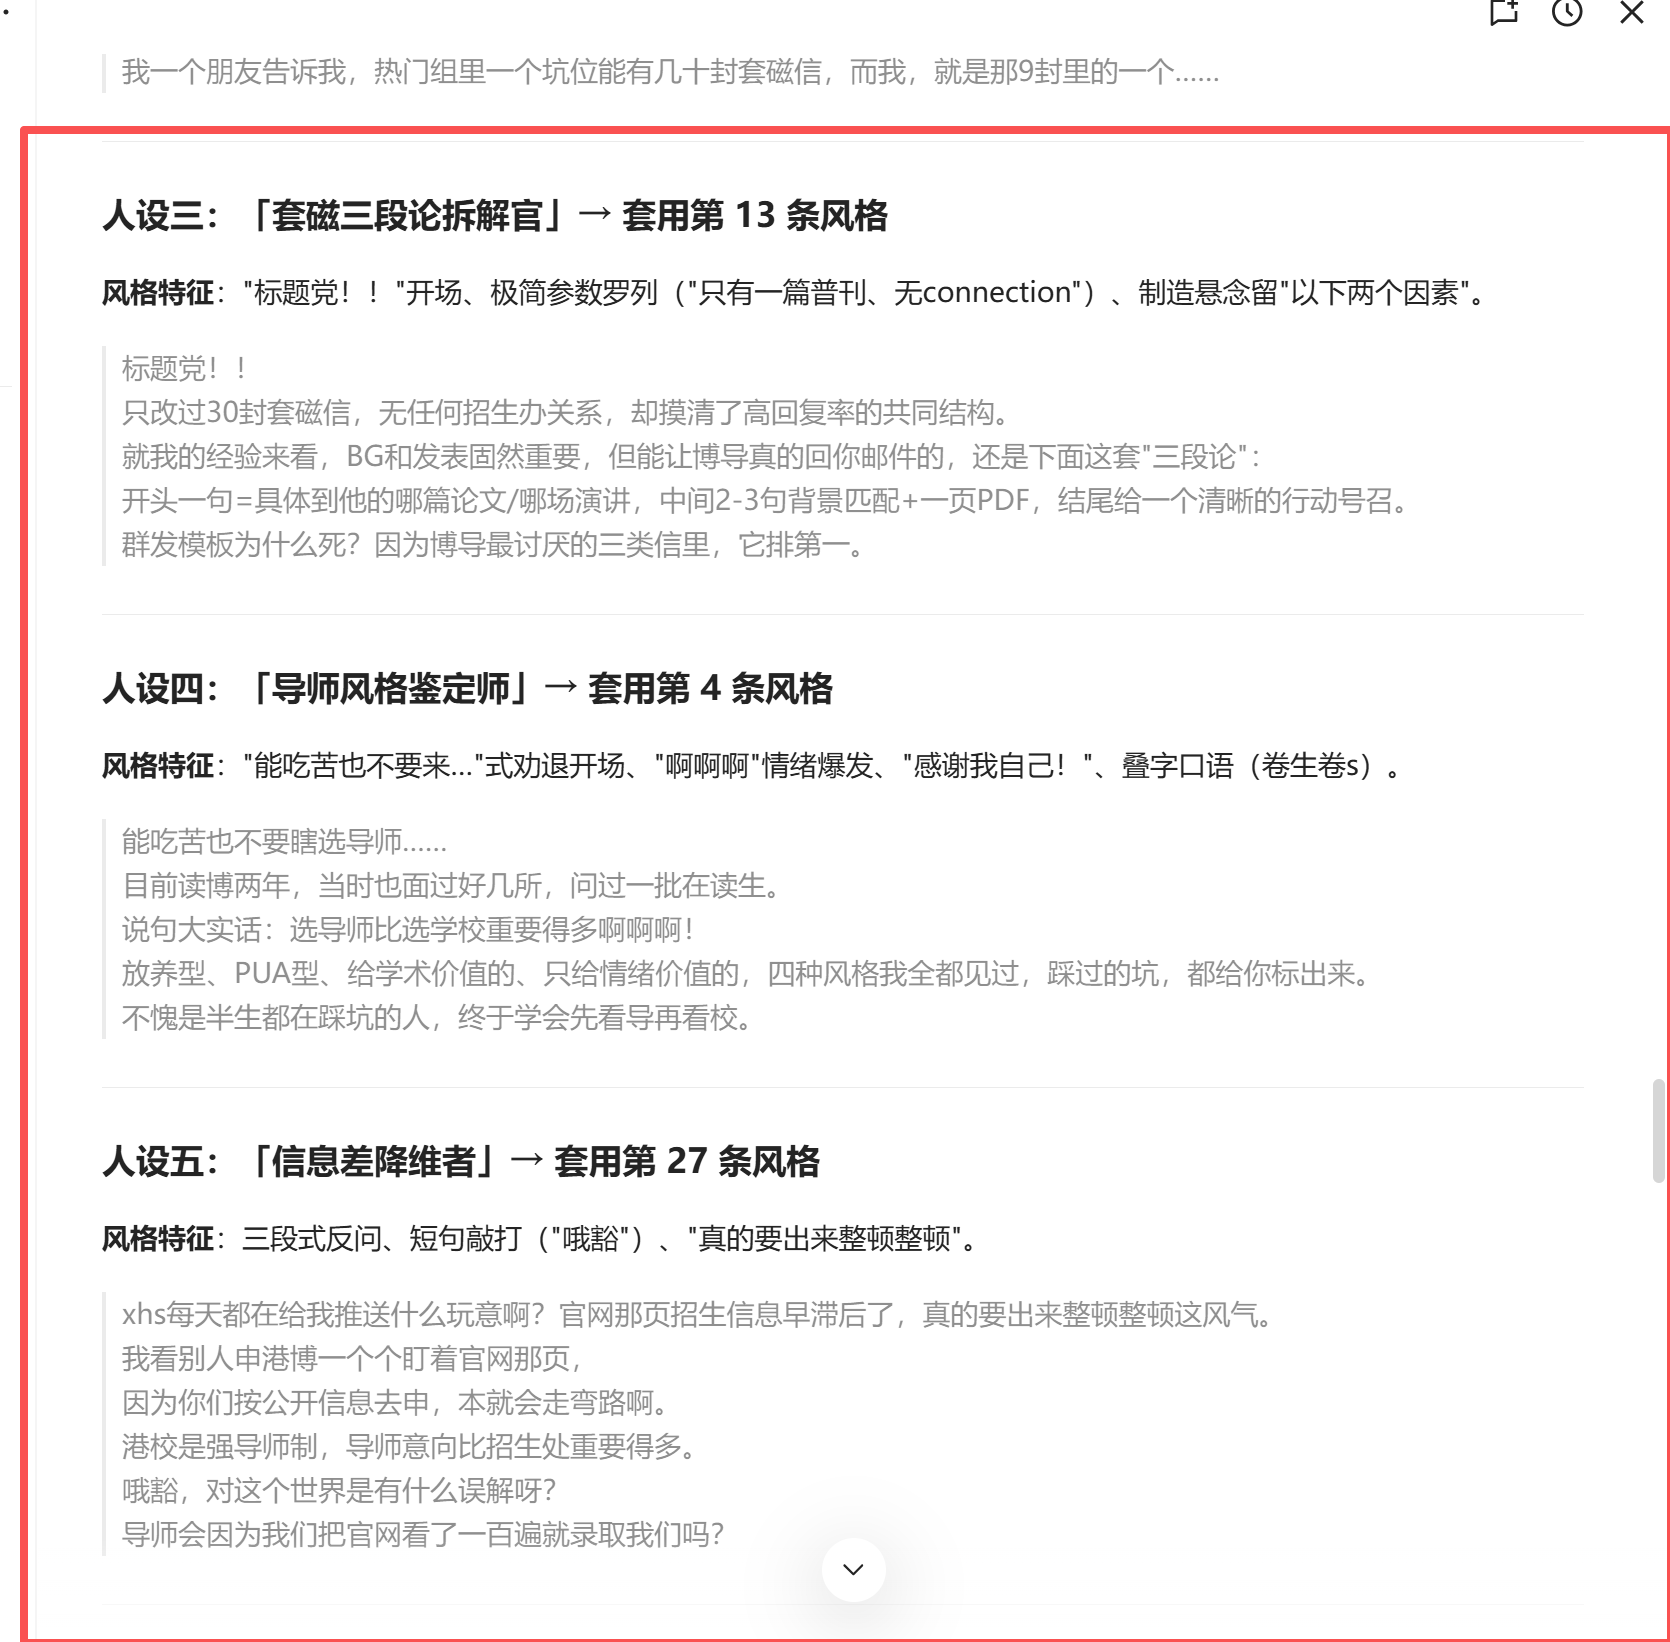
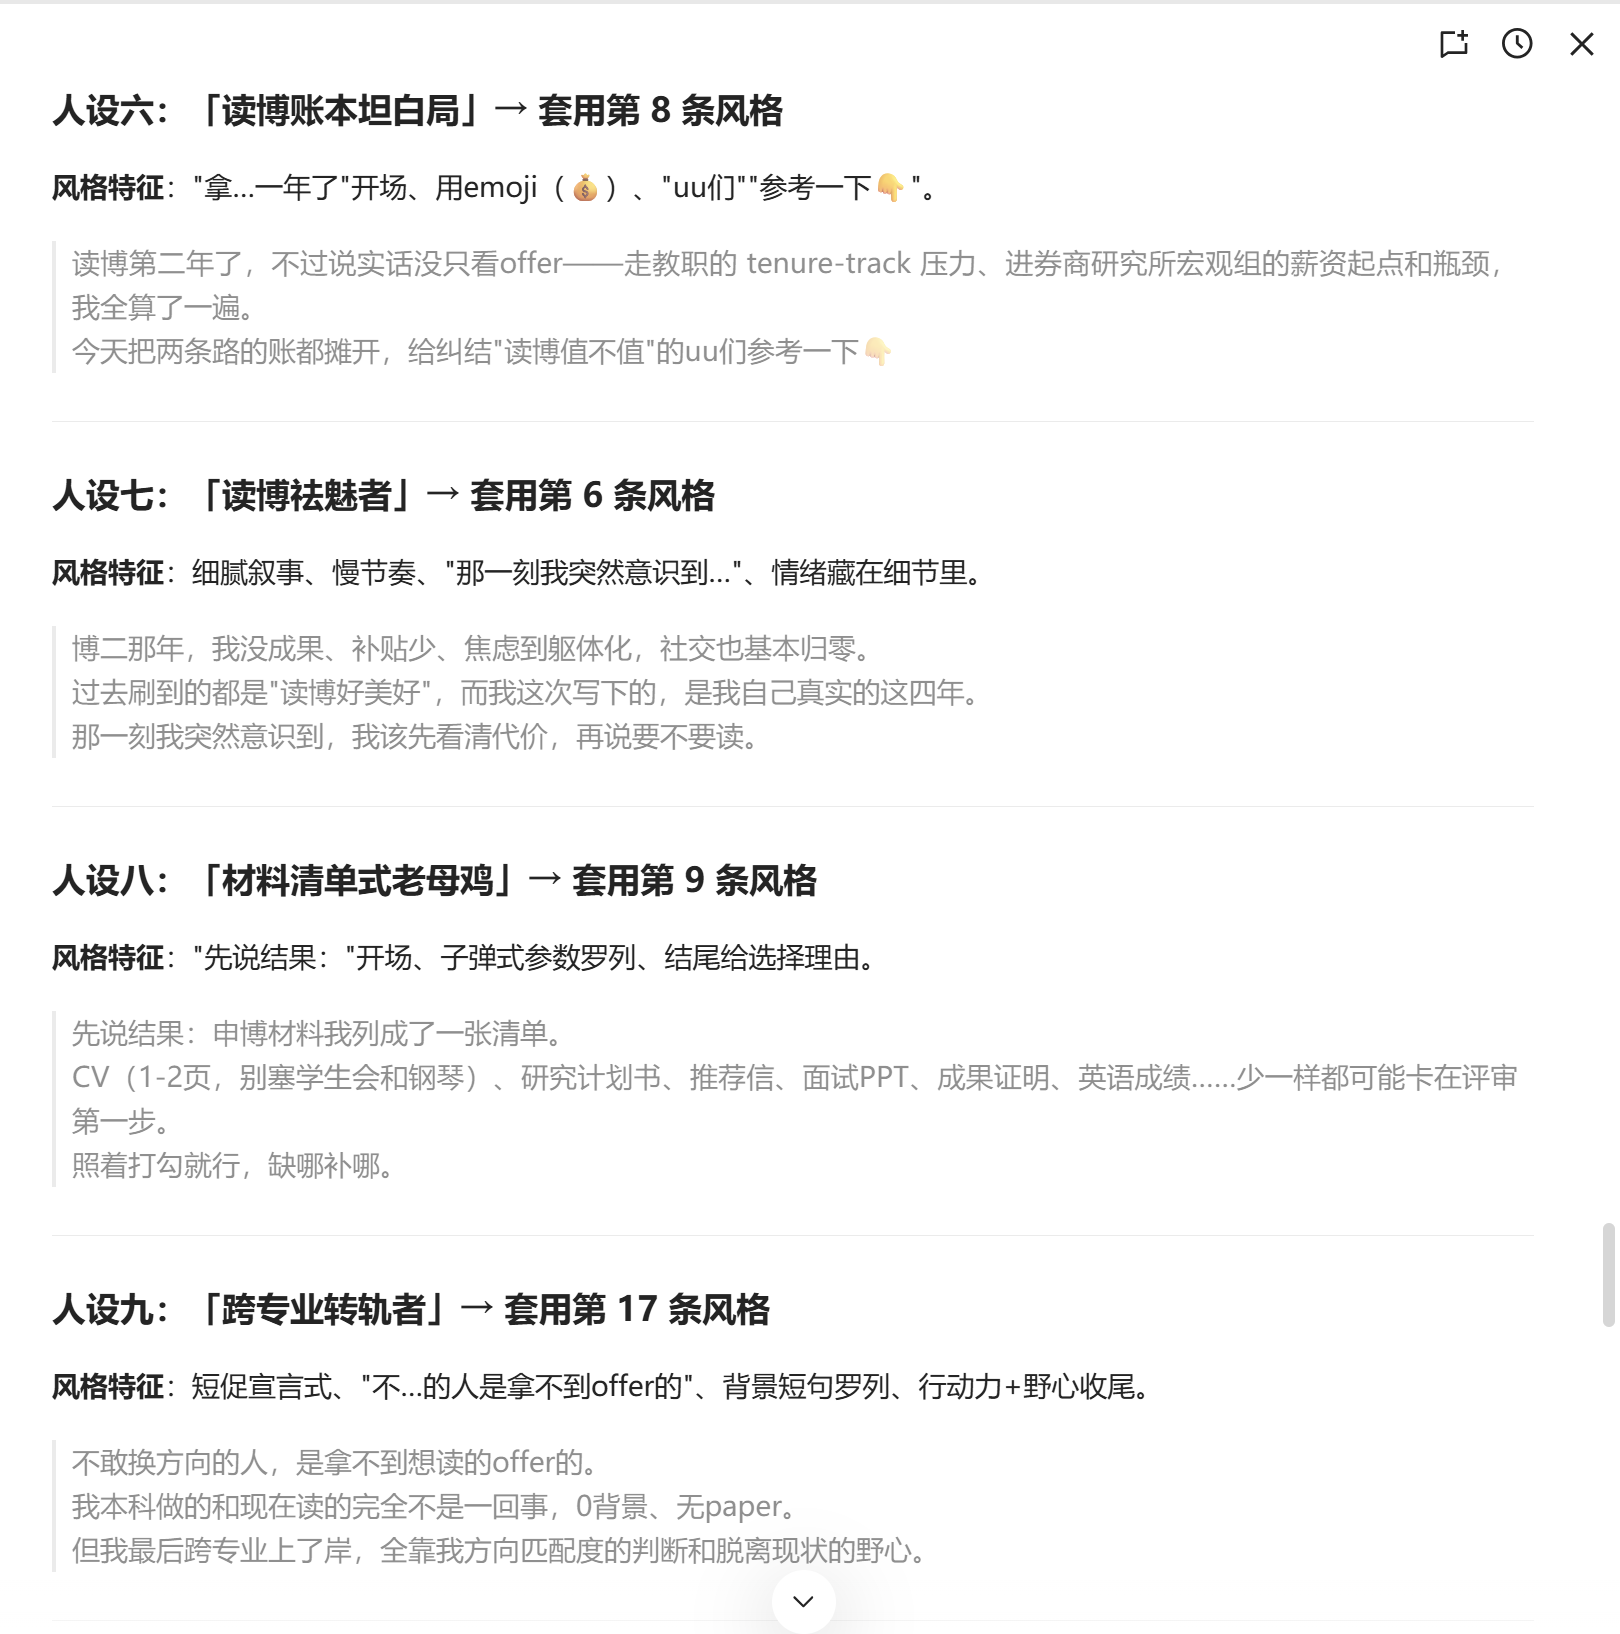
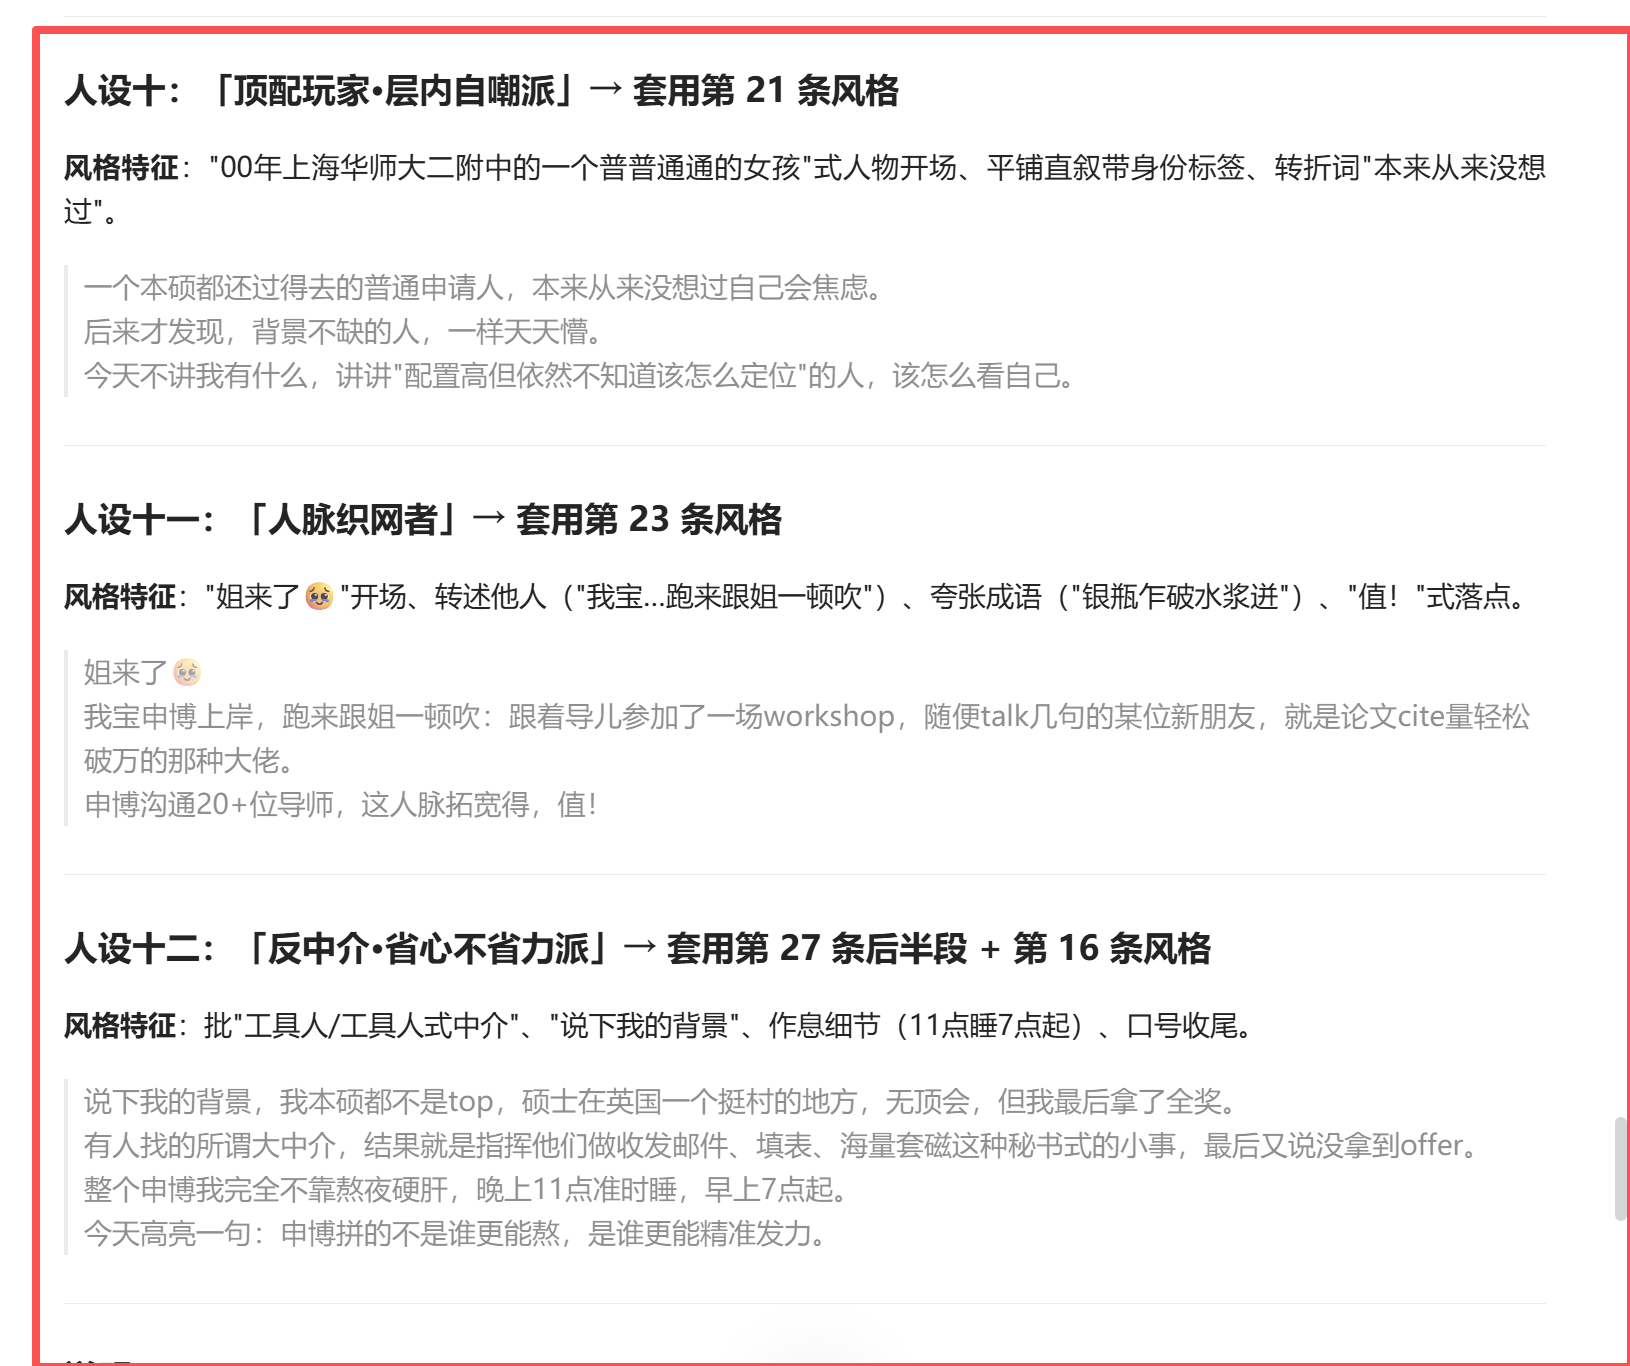
它果然生成得很不错。
但是它也有做得不好的地方,这就需要我们手动调整一下了。
所以,我们能不能快速生成一个好的爆款开头,
一个是取决于我们【内部的定制知识库】,
一个是取决于我们挑选的【外部免费知识库】长什么样。
比如我在贴图号里面找到的知识库,
都是非常适合小红书的;
但是我在自媒体十万+标题里面找到的这个知识库,
写出来的申博赛道开头,都不太对劲。
原因就是这个知识库本身不适合我这个赛道。这个知识库的文风全透露着一种:卖知识付费的、做微商的或者割韭菜的说话风格,
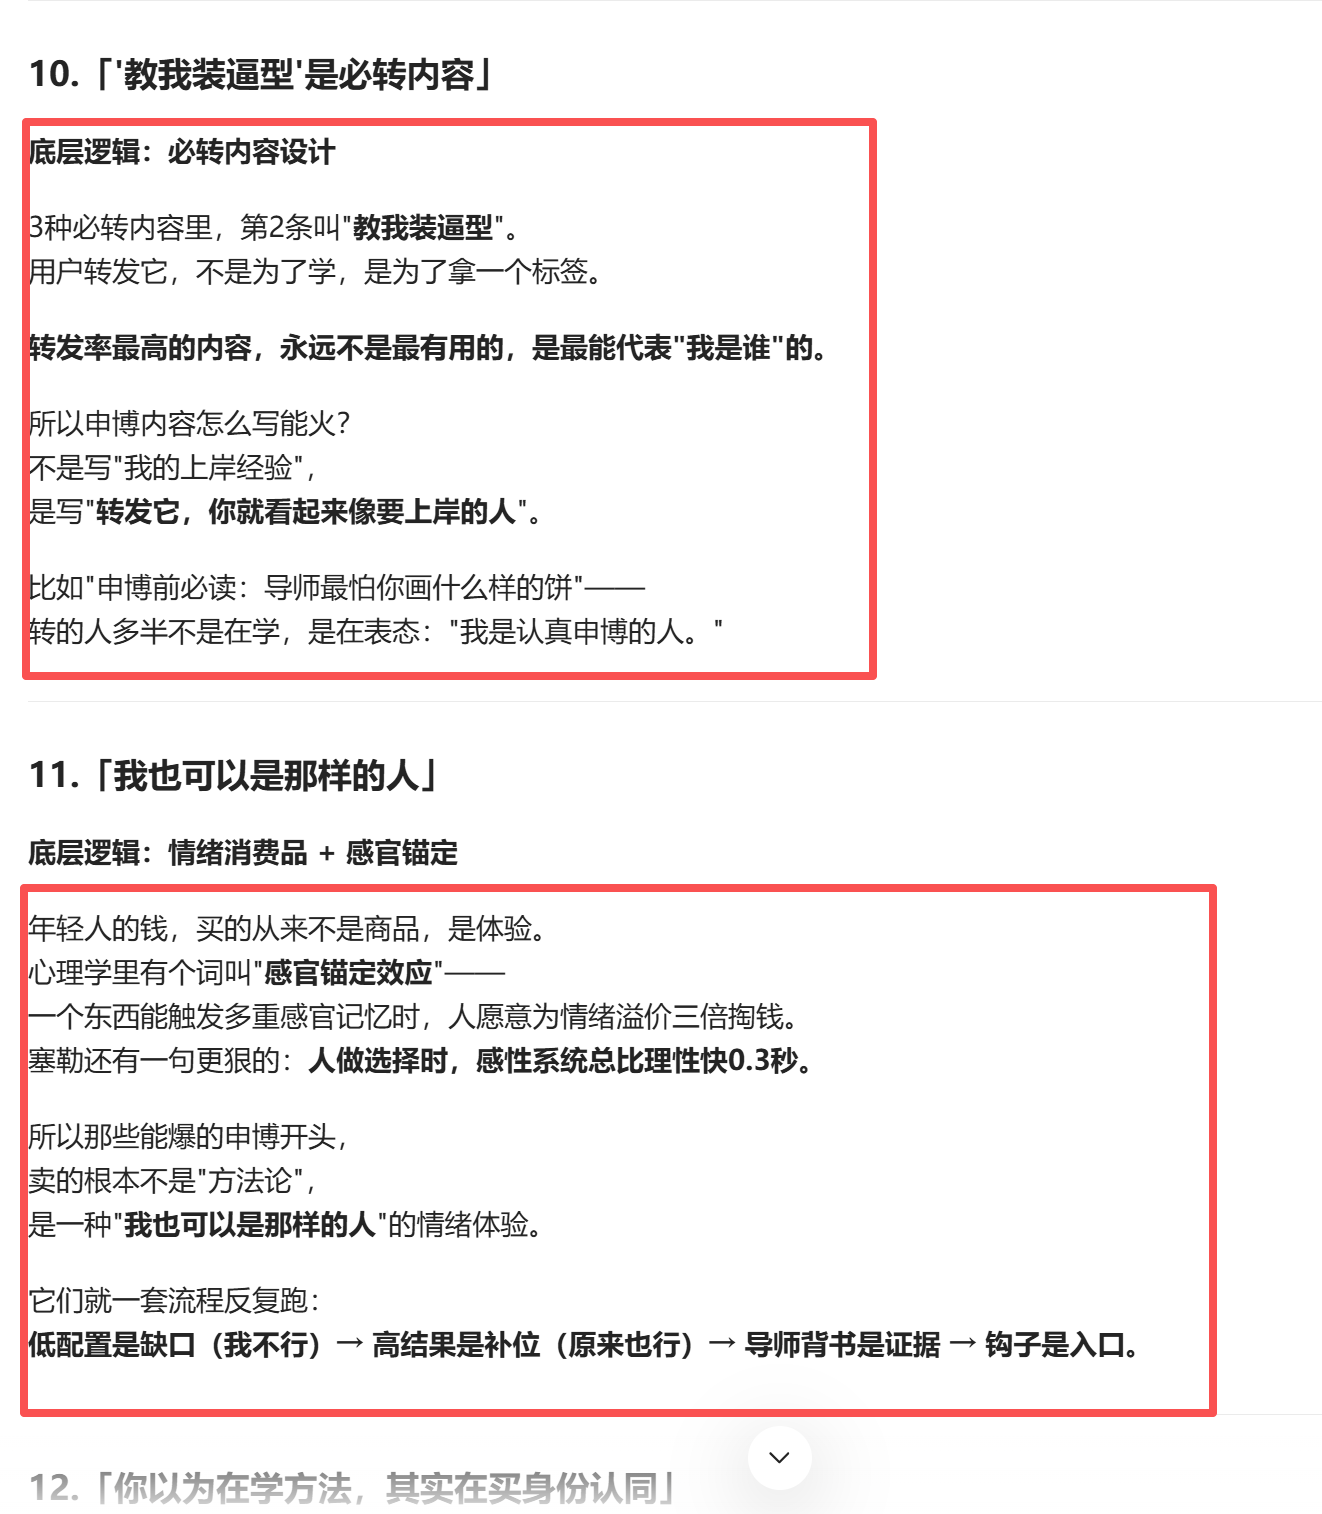
所以这个知识库我就没怎么用。
还有一个知识库是"小红书爆款笔记写作知识库",这个也勉勉强强,中规中矩吧。
所以知识库的好坏是需要我们自己去测试的。
完整版请加珍妮微信zhenni989


